[Minecraft]数据包教程:从入门到入土
数据包是 Minecraft Java 版在不修改游戏代码的情况下自定义游戏内容的核心机制。本教程从认识数据包开始,带你逐步掌握函数、进度、战利品表、配方、结构、标签、维度等核心功能,从入门到入土。
一. 初始数据包
在教程开始前,我们首先得先认识一下数据包。什么是数据包?
数据包(datapack)是Minecraft在Java版中引入的一种功能,允许玩家在不修改游戏代码的情况下,自定义游戏内容。数据包可用于覆盖或添加新的函数、进度、战利品表、战利品表谓词、物品修饰器、配方、结构、标签、维度、维度类型和自定义世界生成。
以下是常用的功能解释:
①进度(advancements):定义新的游戏目标或成就。
②函数(functions):定义一系列可重用的命令序列。
③战利品表(loot_tables):定义生物掉落或宝箱生成的物品列表。
④谓词(predicates):用于战利品表中的条件判断。
⑤配方(recipes):定义新的物品合成配方。
⑥结构(structures):定义自定义的结构或建筑。
⑦标签(tags):为物品、方块、生物等定义分类或组。
⑧维度(dimensions)和维度类型(dimension_types):定义新的游戏世界或修改现有世界的特性。
需要注意的是,数据包是Java版独有的功能,首次出场于MC的1.13版本,而且往后的版本中,一直都保留了数据包的功能。所以,一个数据包的使用最低版本为1.13,对于数据包其它内容,则要视情况而定。
文件结构:
数据包通常位于.minecraft/saves/<世界名称>/datapacks文件夹中,可以是子文件夹或.zip文件。数据包包含多个JSON和.mcfunction文件,用于定义各种游戏内容。
制作和安装:
玩家可以使用任何文本编辑器创建和编辑数据包文件,数据包采用的是MC内部的指令,这些指令相较于开发MC所用的Java语言更为简洁易懂。只需具备基本的计算机知识和逻辑思维能力,便能利用这些指令开发数据包,因此,它对编程新手来说十分友好。
在单人游戏中,玩家可以通过在创建新世界时选择数据包,或者将数据包拖入已存在的世界的datapacks文件夹中来安装数据包。将其放入文件夹后,将在加载或重新加载世界时为该世界启用数据包。
数据包为MC提供了很多好处,这些好处主要集中在游戏的定制性和扩展性上。
首先,数据包允许玩家在不修改游戏核心文件的情况下,对游戏进行定制和扩展。这意味着玩家不需要担心破坏游戏文件或引发不稳定的bug,同时可以在不同的Minecraft版本间更容易地迁移他们的定制内容。
其次,数据包可以为玩家带来全新的游戏体验。通过添加新的进度、配方、战利品表、结构等,数据包可以扩展游戏的内容和玩法。这不仅可以增加游戏的可玩性,还可以为玩家提供新的挑战和机会。
再其次就是数据包采用模块化设计,这意味着每个数据包都可以独立地添加或删除,而不会影响其他数据包或游戏本身的运行。这使得玩家可以根据自己的喜好和需求,灵活地选择和组合不同的数据包。
而且由于数据包不涉及游戏核心文件的修改,因此它们的维护相对简单。当游戏发布新版本时,数据包开发者只需要更新与新版本兼容的数据包文件,而不需要对整个游戏进行重新编译或修改。
对于玩法多的数据包,它的功能不亚于一个插件,如果将其与资源包结合,甚至可以和模组(mods)媲美。不过,mods与数据包还是有点区别的,Mods通常用于对游戏进行大规模修改,且对全局游戏有效,而数据包则更侧重于对游戏内容的自定义和微调,只争对某一存档。
但是,数据包通过MC内部指令创建自定义内容变得相对简单,对编程新手也较为友好,虽然为玩家提供了自定义游戏内容的便利途径,但其扩展性相较于MOD而言较为有限,可能无法满足复杂游戏机制或全面改变游戏体验的需求。对于完全没有编程或游戏开发经验的玩家来说,学习如何创建和使用数据包可能仍然是一个挑战,而且,数据包功能的实现通常需要玩家对游戏机制有一定的了解。此外,数据包在资源获取、兼容性、对原版内容的依赖、性能影响以及社区支持和更新等方面可能存在一些潜在的问题和挑战。因此,在选择使用数据包时,玩家需要综合考虑自己的需求、游戏环境以及数据包可能带来的限制和风险。
初识数据包后,咱就可以进行下一步了。
二、开发数据包
1.准备工作
在开始写数据包之前,你需要以下几个工具:
(1)Minecraft(Java版,且1.13+);
(2)文本编辑器(便于你编写指令代码,如果不嫌弃,你可以直接使用电脑自带的记事本);
(3)……(为啥是省略号,因为这里还包括一些便于写数据包或指令的软件工具)
特别声明:在接下来所有教程中,我所用到的MC版本为1.20.1,文本编辑器我使用的是Visual Studio Code。由于本文只是数据包教程,并非MC指令教学,不过对于MC指令我会顺带的解释,很多其它指令你可以自行查阅官方WIKI。还有最重要的一点就是,本人并非专业人士,所以对于文章中出现的错误,请大佬轻点喷(x)。
当你安装好Visual Studio Code后,为了后续写指令能够更方便,这里推荐下载2个扩展插件:Data-pack Helper Plus、language-mcfunction。

这俩个扩展插件的功能是为你的Visual Studio Code提供自动补全与校验,通过语法高亮、错误检查、自动补全等,让开发者更方便地编写和调试json和mcfunction文件。
准备工作做完后,就可以开始创建你的第一个数据包了。首先,先找到你MC的游戏目录,而数据包一般存放于.minecraft/saves/<世界名称>/datapacks文件夹中,接下来,你需要在datapacks文件夹中创建一个新的文件夹,这个文件夹的名字由你定,为了方便,我这里命名为test,然后再打开test文件夹,接下来随时准备在里面创建文件。
2.数据包的结构
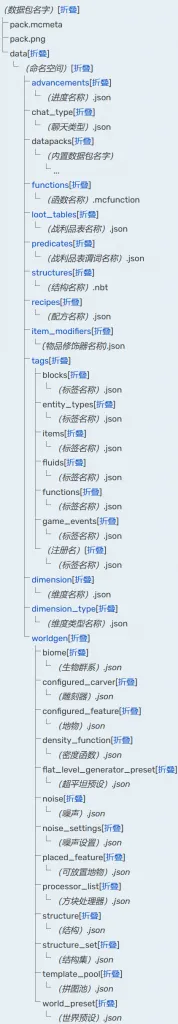
一个完整的数据包结构如图所示,需要注意的是,你的数据包并不需要像图片示的那样完整,你可以选择性的创建文件(夹)。
(数据包名字):即数据包文件的名字,仅仅有让电脑(或者开发者)区分不同文件的作用。在这一篇教程中,根据上文,我将数据包名字命名为了“test”。
pack.mcmeta:数据包的识别文件,是一个包含JSON格式数据的文件,只有这个文件存在时才能被Minecraft识别为一个数据包,你可以理解为是数据包的“身份证”。其格式如下:
1 | { |
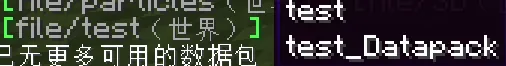
pack_format指示的是期望使用的MC版本,每个版本都对应一个数字,如1.18.2对应9、1.20.1对应15等。description指示的是数据包的说明文字,这一点要在游戏内体现。例如,我在这一项中填写“test_Datapack”,那么在游戏内,当我利用指令列出数据包时,你可以把鼠标指针放在数据包名字上面,它就会显示这个名称。
pack.png:一个像素为64x64的图片,用于展示数据包的封面,可有可无。
data:命名空间总文件夹,存放各命名空间文件夹,用于区分不同的内容,也就是说,data目录下可以有多个命名空间目录。
(命名空间):即命名空间文件夹,可自定义命名。为了便于教学,我们首先创建一个名为abc的命名空间文件夹。
这里还要注意命名空间的命名,命名时名称只能使用小写英文字母、数字、-和_。为了防止数据包之间发生冲突,建议在制作数据包时,尽量不要使用同样的命名空间。同时,当你要覆盖原版数据时,你可以将此命名空间命名为minecraft(后文会细讲)。
命名空间的特性:不同的命名空间目录其中的内容都是独立的,但可以通过指令调用以互相联系。使用相关指令时,注意调用的格式 :<命名空间>:<id或路径>。当缺少命名空间时,会默认使用minecraft命名空间(原游戏的数据包内的)。
以上是一些比较重要的内容,从图中你可以发现,数据包可以包含很多内容,但我们后续的教程只会挑选几个常用的进行讲解,对于剩余的内容,你可以自行查阅WIKI资料。
附:数据包版本编号
编号 版本 3 1.13快照17w43a - 17w47b 4 1.13(17w48a)- 1.14.4(19w46b) 5 1.15(1.15-pre1)- 1.16.1(1.16.2-pre3) 6 1.16.2(1.16.2-rc1)- 1.16.5(20w45a) 7 1.17(20w46a)- 1.17.1(1.18-exp7) 8 1.18(21w37a)- 1.18.1(22w07a) 9 1.18.2(1.18.2-pre1 - 正式版) 10 1.19(22w11a)- 1.19.3 11 1.19.4快照23w03a - 23w05a 12 1.19.4(23w06a - 正式版) 13 1.20快照23w12a - 23w14a 14 1.20快照23w16a - 23w17a 15 1.20(23w18a)- 1.20.1 16 1.20.2快照23w31a 17 1.20.2快照23w32a - 23w35a 18 1.20.2(1.20.2-pre1 - 正式版) 19 1.20.3快照23w40a 20 1.20.3快照23w41a 21 1.20.3快照23w42a 22 1.20.3快照23w43a - 23w43b 23 1.20.3快照23w44a 24 1.20.3快照23w45a 25 1.20.3快照23w46a 26 1.20.3(1.20.3-pre1)- 1.20.4 27 1.20.5快照23w51a - 23w51b 28 1.20.5快照24w03a - 24w03b 29 1.20.5快照24w04a 30 1.20.5快照24w05a - 24w05b 31 1.20.5快照24w06a 32 1.20.5快照24w07a 33 1.20.5快照24w09a 34 1.20.5快照24w10a 35 1.20.5快照24w11a 36 1.20.5快照24w12a 37 1.20.5快照24w13a 38 1.20.5快照24w14a 39 1.20.5预发布版1.20.5-pre1 40 1.20.5预发布版1.20.5-pre2 41 1.20.5(1.20.5-pre3)- 1.20.6 42 1.21快照24w18a 43 1.21快照24w19a - 24w19b 44 1.21快照24w20a 45 1.21快照24w21a - 24w21b 46 1.21预发布版1.21-pre1 47 1.21(1.21-pre2)及以上
2.1命名空间冲突处理
数据包名称我们可以不关心,但是要注意一下命名空间的名称。就如前文所说,命名空间的名称是跟调用息息相关。假设我写了一个函数文件a.mcfunction(路径:test\data\abc\functions\a.mcfunction),其中的指令为say “hello world”(在聊天栏输出“hello world”的消息),那么在游戏中,如果要调用函数的话,你需要使用/function abc:a指令来运行函数文件,由此可见,数据包的任意文件的路径总是从命名空间开始的,而并非从数据包名称开始。
冲突问题:当一个存档含有多个数据包时,载入存档时,系统会按一定的次序加载全部的数据包。当两个数据包各自的data文件夹里含有名字相同的命名空间文件夹时,可能会引发冲突。
若两个文件的路径完全相同,后加载的会覆盖先加载的。我们可以利用这个特性覆盖原版数据包。新建一个存档后,虽然datapacks文件夹内没有任何的数据包,但实际上任何一个存档都加载了一个名为 “vanilla”的数据包。
Vanilla数据包:即MC原版数据包,封装在了游戏版本核心文件(.jar)内,包含了原版和数据包有关的全部内容。例如,杀死僵尸会掉腐肉;挖煤矿会掉煤等。而且,vanilla数据包内有且只有一个minecraft命名空间文件夹;vanilla总是最先加载的,因此任何其它数据包都有机会覆盖vanilla。
当我们想将原版的僵尸掉落物改为“百分百掉落64个钻石”,我们需要用我们写的僵尸战利品表文件覆盖掉原版的僵尸战利品表文件。你只需要在自己的数据包内使用minecraft命名空间,并把改过后的僵尸战利品表文件放在和vanilla数据包存放僵尸战利品表文件相同路径的地方。
2.2 路径
当我们要调用数据包文件时,需要利用路径来表示。路径的调用常用于JSON文件以及/function指令中。其格式为:<命名空间>:<路径>,需要注意的是,对于<路径>,每一层文件夹都要用“/”隔开,如对于test\data\abc\functions\a\x.mcfunction,引用路径为abc:a/x,也就是说,引用某一个文件时,你不需要将文件后缀名也一起写上去。
路径省略:我们在引用数据包内的文件时,有时可以根据指令来省略部分内容。如使用/function指令时,如果我要执行上述文件路径(test\data\abc\functions\a\x.mcfunction)中的x函数文件,那么完整指令应该为/function abc:a/x,而不是/function abc:functions/a/x.mcfunction。
这是因为数据包的文件只在特定的位置引用,像/function指令只用于执行函数,它不可能去引用其它类型的文件,当使用/function指令时,系统会自动定位到functions文件夹,所以这种情况下可以省略。
举一反三,除了function,对于进度文件(advancement)、谓词文件(predicates)、战利品表文件(loot_table)、结构文件(structure)、配方文件(recipes)、物品修改器文件(item_modifiers)也是如此。
3.数据包指令
/datapack指令用于管理和控制数据包的加载和卸载。开发者可以灵活运用这些指令,使得数据包的开发和管理变得更加简单和高效。下面就是/datapack系列指令的介绍。
(1)/datapack disable:禁用某一数据包,注意是使其失效,并非删除。
(2)/datapack enable:使某一被禁用的数据包重新生效,执行该指令后,数据包同时会被重新加载一次。
①/datapack enable (first|last):在启用数据包时,可以指定其优先级。first 将数据包置于所有数据包之前(即优先级最低),而 last 将数据包置于所有数据包之后(即优先级最高)。
②/datapack enable (before|after) :此指令允许开发者在启用数据包时,指定其相对于已存在并加载的数据包 的位置。before 将数据包置于 之前(优先级低于之),而 after 将数据包置于 之后(优先级高于之)。
(3)/datapack list [available|enabled]:列出当前所有的数据包,如果在后面指定available/enabled,则只会列出已生效/被禁用的数据包。
4.JSON文件
4.1 JSON文件介绍
JSON,即JavaScript对象表示法(JSON,JavaScript Object Notation)是一种轻量级数据交换格式。
json文件在一个数据包中经常出现,有的时候,它的数量不亚于mcfuntion文件。Json文件在数据包中主要起到了数据储存、游戏效果定制、键值对存储、数据类型支持、格式规范、易于编辑和共享以及扩展性等作用。
对于数据存储,主要体现在①成书、告示牌、自定义名称以及/tellraw、/title和/bossbar命令里的文本、②描述资源包和数据包的pack.mcmeta文件、③进度和统计、④用于启动器的档案数据、⑤关于已下载的版本的信息、⑥在数据包中定义进度、战利品表、标签、配方、维度、维度类型和谓词的文件。
而接下来的教程里主要描述的是Minecraft中的JSON语句规范,可能与JSON的原始标准定义有所区别,对于具体细节,请自行查阅资料。
在数据包中,有一些文件会以json的形式存储信息,如某一武器有V级的锋利附魔:
1 | {"Enchantments":[{"id":"minecraft:sharpness","lvl":5}]} |
不过有时为了方便查看,会将其格式化,在vs code里,你只需要在打开的文件里,同时按Shift+Alt+F,以格式化文档:
1 | { |
4.2 JSON文件的构成
4.2.1键值对
键值对是构成JSON数据结构的基本单元,我们可以通过键来访问或修改相应的值。键(Key)是一个字符串,用于标识数据;值(Value)是与键相关联的数据,可以是字符串、数字、布尔值、数组、对象(即另一个键值对的集合)或null(null未在Minecraft的数据包标准文件中使用)。
NBT文件和JSON文件都有键值对,但两者的格式有区别:
对于JSON文件,键值对的基本格式为:”<键名>”:<值>。值如果是字符串,则也要加引号(废话);如果是数字,则不加双引号。
对于NBT文件,键名的双引号可以加也可以不加。值则要视情况而定。当值为字符串时,若只含英文大小写和数字,或符号仅含下划线,则双引号可加也可不加;若有除下划线之外的符号,双引号必须加。
例子:Count:64b √ “Count”:64b √ id:grass_block √ id:”grass_block” √
id:”minecraft:tnt” √ id:minecraft:tnt × Count:”64b” ×
(小拓展:64b中的b是byte的缩写,代表Count的值是byte类型)
对于更多有关NBT文件的内容,请查阅WIKI获取更多内容。
4.2.2 布尔值
布尔值用于表示逻辑上的真(true)和假(false),这些布尔值用于标记或设置某些特性或属性。当表示实体的名字,使用CustomName标签,值是字符串;当表示物品数量,使用Count标签,值是数字;当要表达是或不是的时候,就会用到布尔值。
布尔值只有true和false,true表示为真/是(nbt中可以用0b表示),false表示为假/否(nbt中可以用1b表示)。布尔值不是字符串,因此不需要使用双引号包围。
4.2.3 对象
对象以左右花括号作为首尾,包含0个或若干个键/值对,用于描述和定义数据包中的各种内容和行为(对于nbt来说就叫做复合标签)。这些JSON对象通常按照特定的结构和命名约定组织,以便Minecraft游戏能够正确解析和应用它们。需要注意的是,对象内键值对的键名是不能重名的。
在数据包中,对象常出现在pack.mcmeta文件、配方(Recipes)目录、标签(Tags)目录、战利品表(Loot Tables)目录等用得上JSON文件格式的文件中。
4.2.4 数组
数组以左右方括号作为首尾,包含0个或若干个以逗号隔开的数据值。可以用于存储和管理各种游戏数据,如物品数量、方块坐标等(在nbt中称之为列表)。与对象不同,数组内部的元素可以是任一数据类型,元素直接用逗号隔开(键值对不属于数据类型)且元素可重复,而对象内只能是不能重复键名的键值对。
在数据包中,某些信息使用JSON文件格式存储,这些数据通常以键值对的形式组织在对象中,而对象又可以包含在数组中,以实现更复杂的数据结构。比如下面的一串json文件代码:
1 | { |
从上往下读,”Count”是键,64是值(数字类型); “id”是键,”minecraft:grass_block”是值(字符串类型);”CustomName”是键,”My Block”是值(字符串类型);”isEnabled”是键,true是值(布尔类型);”items”是键,后面的数组是值(数组类型)。
5. 标签
5.1 标签介绍
在MC中,标签有很多种,第一种是指令/tag ,可以向实体添加/删除标签,这个标签伴随着实体存在;第二种是物品tag,是物品的nbt之一,在物品的tag复合标签里,可自定义;第三种就是之前说过的NBT格式,标签一词也泛指NBT;第四种为标签文件,用于将若干同类型的事物定义为集合的文件,数据包的构成之一。而本教程主要讨论标签文件。
在数据包中,标签文件允许玩家在不修改游戏代码的情况下,通过JSON格式的文件对游戏内容进行自定义分组。标签是技术性的JSON文件,存储于数据包的data/<命名空间>/tags/<注册名>目录下。注意,/tag命令添加的“标签”并不是该条目的“标签”。
标签文件扮演着至关重要的角色。它们通过将游戏对象(如物品、方块、生物等)分组,并为其定义特定的行为或属性,从而大大增强了游戏的可定制性和扩展性。
具体来说,每个原版标签都可能在游戏源码中作为某些执行和调用行为的限定条件,这意味着标签可以直接影响其所包含对象的行为。例如,方块标签可用于控制和判断各种方块的行为(比如方块是否能被攀爬和挖掘),物品标签可用于控制和判断物品的行为*(比如物品是否能被染料染色),而实体类型标签则可用于控制和判断各种生物的行为(比如是否被视为节肢生物,这会影响节肢杀手魔咒的作用对象)*。
此外,原版进度文件和原版配方文件也会利用标签来实现某些条件判断,这使得玩家和开发者能够更灵活地设置游戏目标和制作配方。更多用途可以查看WIKI。
因为标签文件可以将若干同类型的事物定义为一个集合,所以我们可以利用这一点简化指令:
例如,现在需要执行三条这样的指令:
/kill @e[type=minecraft:creeper]
/kill @e[type=minecraft:spider]
/kill @e[type=minecraft:zombie]
一个一个的去执行,会显得麻烦,如果转换为标签文件:
1 | { |
然后上面的三条指令就可以简化成:/kill @e[type=#<标签文件路径>],这样是不是更简单了点?
5.2 标签文件的编写
5.2.1 语法和参数
其实上文间接的提到过,标签文件采用的是json文件格式,因此,标签文件要严格按照json文件的格式来编写。在前面的标签文件示例中,出现了两个(键名)参数:replace和values。
replace:值为布尔值。当为true时,表示会按照数据包同名冲突的规则覆盖同名文件,此时被覆盖的标签文件会失效;当为false时,表示会和同名文件的内容取并集,一起被使用。一般情况下,replace的值为false较好。
values:值为一个数组,包含属于该标签的所有对象的ID。这些ID通常是命名空间前缀与对象名称的组合。在编写的时候需要注意以下规则:
①当写入的内容为原版内容时,直接用字符串的形式:
1 | { |
②当引用另一个标签时,使用#作为开头,并加上该标签文件的路径:
1 | { |
③当要写入非原版的内容时(注意:系统在读取数据包时,会进行检查,当检查到有内容不存在时,该文件整体失效):
1 | { |
可以看得出来,上面的例子是引用了暮色森林模组的内容。假设并未安装该模组,那么这一串代码包括整个文件都无意义。为了避免这种情况发生,我们可以将其修改成对象,把内容作为一个id的值,并将required的值设置为false:
1 | { |
这样一来,即使未安装相应模组,系统也会忽略该条目,从而这个文件依然生效。
5.2.2 路径
当我们引用一个标签文件时,应该加上“#**”,格式:#<命名空间>:<…>。**对于标签文件的路径省略,就如前文所说,标签文件的路径也有它自己的省略规则。
比如引用test/data/abc/tags/blocks/foo/example.json,可以写成#abc:blocks/example。
5.3 特殊函数标签
函数标签可以在/function命令中以#<命名空间ID>的形式调用。所有在该标签中指定的函数都会按照它们第一次出现的顺序执行。另外,在minecraft命名空间下包含了两个拥有特殊行为的函数标签:load标签和tick标签。
load.json:标签内指定的函数会在数据包加载时自动执行一次,常用于数据包的初始化操作。需要注意,这些函数在玩家进入世界前就被执行,这意味着无法使用目标选择器来找到玩家。因此,诸如/tellraw和/title命令将不会对任何玩家显示。
tick.json:标签内指定的函数会在每个游戏刻执行一次。也就是说,当数据包开启后,会直接无条件执行tick标签内指定的函数。当然并不是所有的高频函数都要写在tick里,tick标签内的函数应该是无条件的、占用小的、逻辑优先级较高的、需要高频执行的函数。
注:在minecraft:tick标签中的第一个函数将在minecraft:load中的函数运行前运行。这意味着,假定minecraft:tick中依次有tick1、tick2、tick3,minecraft:load中有load1,则/reload后函数的运行顺序为:tick1、load1、tick2、tick3…
6.函数
6.1 函数的介绍
在数据包中,函数(Function)是一个可包含多行命令的.mcfunction文本文件,存储于数据包中的data/<命名空间>/functions目录下。作为文本文件,函数可以很容易地被修改(只要记住在修改完后使用/reload指令重新加载),并且在执行大量命令时更不容易像命令方块一样造成延迟。命令/function可用于调用函数。
需要注意的是,数据包中函数遵循一下规则:
①函数仅存放在data/<命名空间>/functions目录下,其文件后缀名为.mcfunction;
②函数文件中的指令不用加“/”,且每一行只能写一条指令;同时,你可以在函数文件里写入任何原版MC或者来自模组的指令;
③对于一行命令,如果在末尾使用反斜杠“\”,则允许在下一行添加后续部分。后续行的前后两端的空白会被截去,并尝试承接上一行命令。这提供了一种将单行命令拆分为多行书写的方法;
④函数文件中,使用“#”可将文字变为注释(注释后的内容不会被执行),需要注意的是,注释和指令不能在同一行;
⑤当调用函数时(或者说执行函数时),游戏会从上往下执行函数中的每一条指令,如果函数内调用了其它函数,则会先执行内嵌的函数,再返回原函数里顺序执行后面的指令。;
⑥执行函数时,MC会在一个游戏刻内无条件地执行完该函数内的全部指令,注意,原版MC默认单个游戏刻的指令执行上限为65535,超过此数量限制的命令将在运行时被忽略,不过可以通过/gamerule指令修改(maxCommandChainLength);
⑦载入数据包时,MC会对所有函数进行检查。如果一个函数内出现了一个或一个以上的错误,则整个函数均失效,不过这一规则对宏函数不起作用(详见:宏函数)。
6.2 函数的调用
函数可以用不同的方式从数据包中的其他文件调用,有以下三种方式:
(1)通过指令:可以使用/function命令调用函数。一个单独的函数可以通过其命名空间ID来调用;多个函数形成的组可以通过函数标签一次性调用。
(2)通过进度:达成一个进度时,可以使用rewards来调用一个函数。被调函数的执行者即是达成进度的玩家。设置调用函数的进度JSON格式如下:
1 | { |
(3)通过函数标签:函数可以通过数据包中的标签组合到一起。标签中的函数将以其定义顺序从上到下依次执行。如果同一函数多次出现,则只在首次出现时执行。
①主动调用:可以通过/function #(命名空间):标签命令来主动调用一个函数标签包含的若干函数。
例如:function #example:example_tag
则调用了example命名空间下tags/functions目录中的example_tag.json文件中列出的所有函数。
②被动调用:即前文所讲有关load标签和tick标签的内容,详情见前文特殊函数标签。
当被调用(执行)时:函数每次被调用时,都将在一游戏刻内运行其中的所有命令,包括其中通过/function命令执行的子函数,也将在同一个游戏刻运行。
函数会将当前函数调用者的参数(包括命令的执行实体,以及执行位置、朝向、维度和基准点)存储到执行上下文中,并将其中的上下文参数直接提供给每条命令。
在同一函数内,/execute命令可以改变当前命令的上下文,但不会传递该影响到之后的任何命令。若为被动执行,执行者为服务端(名称显示为“Server”),执行位置为世界出生点。
说成人话就是,在一般情况下:
(1)当由函数直接执行函数时:
①执行位置:主世界出生点;
②执行实体:无(但会显示是server执行了函数);
③执行维度:主世界(废话);
④执行朝向:X轴正方向。
(2)当由玩家在聊天栏执行函数时(/function …):
①执行位置:该玩家所处位置;
②执行实体:该玩家;
③执行维度:该玩家所处维度;
④执行朝向:该玩家朝向。
当然,如果函数内的指令对执行者和坐标都已经设置好了,则要根据这些参数进行判断。比如,玩家在聊天栏输入/execute positioned ~ ~1 ~ run function … ,这样执行的位置就会往上一格(玩家所处位置的Y坐标+1)
6.3 schedule指令
在MC中,schedule指令以服务端为执行者,在经过指定的时间后执行函数。也就是说,你可以人为的设置一个时间,经过这一段时间后才会执行指定的函数(需要注意的是,schedule指令是在1.14~1.15加入进来的,因此,要使用该指令时最好使用1.15+)。
6.3.1 schedule指令的用法
对于schedule指令,有以下用法。
用法一:/schedule function <函数> <时间> append/replace
含义:为某个<函数>创建计划,在经过<时间>后执行。
<函数>:指定的某一个函数,可以是函数标签。
<时间>:正整数+时间单位。注意在MC中的时间单位和现实的有所不同(t-游戏刻(无单位时默认),s-秒(1s=20t),d-游戏日(1d=24000t))。
append/replace:append-添加等待运行的函数或指定标签里的函数;replace-取代还在等待运行的函数或指定标签里的函数,被取代的函数或指定标签里的函数将不会运行(仅取代相同函数名称和命名空间的目标)。
如果我们对一个函数创建了计划,且该计划还未完成,然后对该函数又创建了一个计划,也就是一个函数有不止一个计划,此时需要考虑覆盖和独立。覆盖即replace,表示覆盖原先的计划;独立即append,表示这两个计划互相独立。
用法二:/schedule clear <函数>
含义:清除<函数>的全部计划。需要注意的是,此语法是在1.15版本加入的。
6.3.2 schedule循环
假设一个函数是这样的(路径:data/foo/functions/test.mcfunction):
give @a minecraft:apple 1
schedule function foo:test 1t append
这样写相对于为这个函数自身创建了一个计划,当执行该函数时,它会一直循环执行,直到使用/schedule clear foo:test后才停止循环。
这样的好处是形成了一种临时性的循环,这个循环是可控的且循环的间隔时间是可调的。不过,优先级会比tick标签里的更低。
6.3.3 schedule指令的误区
误区一:假设test:abc中包含两个函数:test:x、test:y。当我们执行/schedule function test:x 1d append和/schedule function test:y 1d append后且要清除两个计划时,/schedule clear test:x和/schedule clear test:y并不与/schedule clear #test:abc等价。
你可以这么理解,/schedule clear #test:abc仅是清除了该函数标签的计划,对其内部指向的函数无关。当一个计划设定后,它所计划的函数只有在执行时才有意义,就好像只有执行时才能“发现”函数的内容,此时函数标签才能与函数标签指定函数等价。
误区二:当你在聊天栏输入/schedule function test:abc 5t append后,经过5游戏刻后,这个函数会继承玩家的执行环境再执行指令吗?
并不会。这是因为,/schedule指令仅仅是一个创建计划的指令,时间到后函数的执行环境与数据包默认的执行环境相同。
*6.4 return指令
在MC中,return指令可以被写入一个函数中,以控制函数执行。它可作为其所在函数的结束点,并设定该函数被调用后的返回值为一个整型数值。通过设置返回值为某数值,它可被用于记录带有条件分支的/function命令的执行结果,以及反映它们随后的执行情况。
大概的意思就是,return 指令可以被用于控制函数的执行流程,并通过返回一个整数值来传达函数执行的结果和状态。若函数中存在return,则当某条return命令执行时,会中断当前函数的执行,之后的命令都处于终止状态。
利用返回值机制,可有效剔除无用的执行分支,从而提升函数运行效率。也有助于实现更灵活的状态判断和执行控制。
语法:
(1) return <值>:终止其所在函数,并设置此命令的返回值为一个整型数值(范围在-2,147,483,648到2,147,483,647之间)。此语法在1.20加入。
(2) return fail:终止其所在函数,并设置此命令的返回值为0。此语法在1.20.3加入.
(3) return run <指令>:执行指定的命令,终止其所在函数,并将此命令的success(成功次数)和result设为其所在函数的返回值。若<指令>执行失败,则返回0。若<指令>为一个多分支的/execute,则仅第一个分支命令会被执行。此语法首次在1.20.2加入,但后面移除过一次,保险起见,如果你想要使用return run 指令最好使用1.20.3+。
例子:
①使命令结果为20:
/return 20
②使命令结果为0:
/return fail或*/return 0*
③使命令结果为/scoreboard players get <目标> <计分板>的返回值(即<目标>在<计分板>上的分数):
/return run scoreboard players get <目标> <计分板>
当然,我们可以灵活运用return指令:举个例子,你可以利用return让某一个函数被执行后返回一个值,这个值你可以通过/execute store [result|success] score @p <计分板> run function <函数>来存储这个值(假设你已经创建了一个计分板,且为指定玩家设置看该计分板;<函数>最后要有return指令),如果不确定,你可以使用/scoreboard players get @p <计分板>查看此时计分板的分数。
而关于参数:result和success,它们的用法可以参考下面的表格:
| 命令 | 条件 | 成功次数 | /execute store success … | /execute store result … |
| /return |
成功时 | 1 | 1 | value参数的值 |
| 失败时 | 0 | 0 | 0 | |
| /return fail | 成功时 | 0 | 0 | 0 |
| /return run |
成功时 | 1 | 通过/function间接调用,输出1,否则无输出 | 通过/function间接调用,输出 |
| 失败时 | 0 | 通过/function间接调用,输出0,否则无输出 | 通过/function间接调用,输出0,否则无输出 |
……
*6.5 宏函数
基本概念
“宏”主要表现为以“$”开头的宏命令。每条宏命令被执行后都可能会在内部被动态解析为多行普通命令。包含宏命令的函数称为宏函数。需要注意的是,宏函数首次出现在1.20.2版本。
使用方法
举个例子,假设我写了一个只含setblock 0 1 0 stone指令的函数(setstone.mcfunction),很明显,当我执行该函数时,会在坐标为[0,1,0]处放置一个石头方块。
现在我将其转换为宏函数:$setblock 0 $(y) 0 stone,随后调用/function test:setstone {y: 1}和/function test:setstone {y: 3}即可实现在坐标(0, 1, 0)和(0, 3, 0)填充石头。
其核心原理为将以上宏命令解析为2条普通命令后再执行:
setblock 0 1 0 stone
setblock 0 3 0 stone
当然,一个宏函数可以包含多个宏参数,比如我们可以根据相同的改法,对上面setblock指令的x、z坐标进行宏参数化:$setblock $(x) $(y) $(z) stone,我们就可以利用这个指令:/function test:setstone {x:<X坐标>,y:<Y坐标>,z:<Z坐标>}进行直接传参。
同时,你也可以通过获取命令存储数据、方块数据、实体数据来间接传参。用法如下:/function <某一个需要传参的宏函数> with <block|entity|storage> <传参属性>。这条指令的意思是,获取方块|实体|存储的值,并将其传入宏函数对应字段的宏参数内。对于<传参属性>,你可以通过类比/data指令子命令分支。
如果你希望按需传参,要注意按需传参的流程:清除—取参—传入。举个例子,假设我们有一个名为test:data的命令存储,要将其内部的args下的id和count值传入宏函数test:hong对应的id和count宏参数内:
1 | # 清除数据 |
[此段内容待求证]对于传参,我们可以传入各种数据类型,那么我们是否能传入一个特殊的参数,使其能够修改原先宏函数的内容?答案是可以的。假设有一个宏函数:$data merge entity <目标选择器> {CustomNameVisible:1b,CustomName:'{"text":"$(text)"}'}。我们给$(text)传入:”}’,NoAI:1b,那么传参后的宏函数为data merge entity <目标选择器> {CustomNameVisible:1b,CustomName:'{"text":""}',NoAI:1b},这样的话,我们借助传参功能间接修改了指令的内容。
总结
宏函数会根据传入的参数动态地替换宏行中对应的变量字段,然后进行语法检查,若无任何异常则解析成功,否则失败——整个宏函数也将因此而无法运行。需要注意的是,宏函数和普通函数不同,它不像普通函数加载时会直接检查函数文件那样,只有在宏函数被解析时才会进行检查。需要注意的是,在给宏函数传入参数时,可以多传,但不能少传。同时,传入参数必须是一个nbt复合标签。
附:宏函数特性和用法
7.配方
配方由数据包配置,从其中读取数据。所有的合成、烧炼、冶炼、营火烹饪、烟熏、锻造和切石配方都使用这个系统。在数据包中,配方是技术性的JSON文件,存储于数据包的data/<命名空间>/recipes目录下。命令/recipe可给予或剥夺玩家的配方。首次加入于1.12,在1.15及后续版本逐步完善。
配方正如战利品表一样,也可以通过命名空间冲突的方式覆盖原版数据包内的配方,以此修改原版的配方。这里我们以金苹果的配方为例子,进行讲解。原版的金苹果配方的json文件是这样的:
1 | { |
我们来逐行解释一下各个键值对的含义。
type:表示配方的类型,minecraft:crafting_shaped则表示这是工作台的一个有序的合成配方,玩家必须按照后面定义的物品排列顺序进行合成。
category:可选项,决定该配方出现在配方书中的哪个标签栏,取值可为:building(建筑)、redstone(红石)、equipment(装备)和misc(杂项)。
key:所有该有序合成配方用到的键,每个键都是一个字符。其中的“#”与“X”则是两个键名,可自定义。两个键内包含的item则表示当前键匹配的物品。
result:其中的item表示该配方的输出物品。
show_notification:(可选)表示当前配方解锁后是否弹出相应的提示。
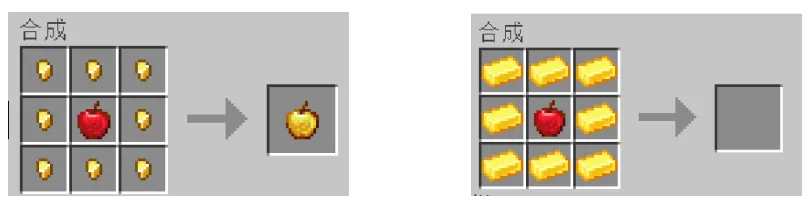
那么上面的配方表示一个金苹果的有序合成配方,玩家需要在工作台内按照如下图的物品摆放顺序进行合成:
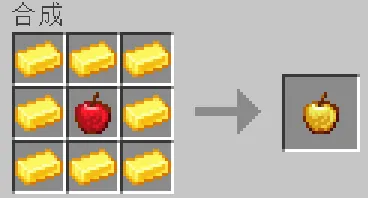
现在我们创建一个新的数据包,用来修改原版金苹果的合成配方。在这里我创建一个名为More_Recipes的数据包进行演示。以下就是我修改后的新配方(路径:More_Recipes\data\minecraft\recipes\golden_apple.json):
1 | { |
可以看到,我将原版金苹果的合成配方中的原材料——金锭替换成了金粒,而且由于命名空间的冲突,我的配方已经覆盖了原版的配方,一旦加载了这个数据包,你就可以在游戏中使用金粒进行合成金苹果,同时原先的配方已经失效。
上述例子中,我们介绍了工作台的有序合成配方的创建和修改,这仅是配方系统中的冰山一角。其实在我的世界中,配方有很多类型,如工作台配方、烹饪和烧炼类配方、锻造台配方等,每一种类型的配方都可以进行自定义,这极大的丰富了玩家在我的世界的游玩体验。在这里我会提供一个自创的配方数据包,读者可以自行下载学习研究,当然也可以随意魔改和使用:More_Recipe
8.谓词
谓词(Predicate)是在数据包中多处出现的JSON结构。通过多种方式调用谓词,可检查世界中的各种情况。谓词会返回“通过”或者“失败”给调用者,调用者也将基于此结果进行不同的处理。简单概括就是谓词可以实现更加复杂和灵活的条件判断。
在编写一个自定义谓词文件时,要求你打开有关谓词的WIKI,方便在编写过程中查找关键字段。例如,我要写一个用于判断当前区域亮暗程度(光照强度)的谓词,我们需要找到关键字段location_check,即检查当前位置。而亮暗程度(光照强度)我们可以利用该字段下的light位置信息谓词来判断,最后利用light下的min和max字段用于划定界限范围。根据上面的描述,创建一个名为light.json的谓词文件:
1 | { |
这个谓词文件的作用是,在指令执行环境下,当光照强度在1.0~15.0范围的时候通过测试。我们可以利用/execute if predicate指令或者利用目标选择器来设置判断条件,并调用这个谓词文件使之生效。
此节正在持续更新中……
9. 战利品表
9.1 基本概念
在数据包中,战利品表(Loot table)是一种技术性JSON文件,存储在数据包的data/<命名空间>/loot_tables目录下。战利品表用于决定在何种情况下生成何种物品。比如自然生成的容器和可疑的方块内容物、破坏方块时的掉落物、杀死实体时的掉落物、钓鱼时可以钓上的物品、猪灵的以物易物。它不会影响经验的掉落和不掉落物品的实体,比如大型史莱姆产生的史莱姆和虫蚀方块中的蠹虫。
在MC的1.9版本中,战利品表被首次引入,而后的数个版本都致力于对战利品表的功能进行持续的完善与扩展。若你想要使用自定义战利品表,那么推荐使用1.15及更高版本。
9.2 基本功能
战利品表可用于修改容器中的物品生成或生物掉落物。可修改已经存在的战利品表(可以通过加载自定义的数据包来覆盖minecraft命名空间下的同名文件,以修改原版物品生成行为),也可创建新的战利品表。注意,一些方块,比如基岩、末地传送门和其他在生存模式中不可破坏的方块都没有战利品表。
一些方块会共享战利品表(即方块的墙和地板变种),不过由于它们原版游戏中并非是容器方块,所以这个战利品表在正常情况下你是无法通过用非指令的方法获取的。不过你可以利用指令生成一个容器方块,让它继承这个战利品表。
举个例子:假设你在某处利用指令放置了一个带有特定战利品表的信标(信标不属于容器方块),随后通过指令在这个位置放置了一个箱子(将信标替换),这个箱子就会继承之前信标的战利品表,而又由于箱子是容器方块,所以你可以直接打开查看里面的物品(即战利品表的物品)。
9.3 使用方法
正如前文所说,战利品表可用于修改容器中的物品生成或是生物掉落物,可对已经存在的战利品表进行修改,也可创建新的战利品表。接下来我们就来试着创建一个战利品表并且利用指令生成一个包含该战利品表的箱子。
我们可以利用战利品表定义一个宝箱,其中包含了以不同概率和数量生成的荧光石、石头和石剑,下面是完整的战利品表代码(Chests\data\loot_tables\loot_tables\items.json):
1 | { |
我们来逐行分析一下各个部分的功能:
"type": "minecraft:chest"指定了这个战利品表的类型是minecraft:chest,意味着它用于定义宝箱中的内容;"pools":[{<池子1>},{<池子2>},...]定义了多个“池”,每个池都定义了一组物品及其生成规则;"rolls": 5指定了基本滚动次数(即尝试从该池中抽取物品的次数);"bonus_rolls": 6指定了额外的滚动次数(基于某些条件,如玩家击杀怪物的难度或宝箱的特定属性);"entries": []包含了该池中可能生成的物品;"type": "minecraft:item"指明了物品的类型;"name": "minecraft:netherite_ingot"指定了物品;"weight": 3决定了这个物品堆被选择的基础权重(可选);"quality": 3则是基于战利品上下文实体的幸运修改物品堆被选择的权重(可选);"conditions": []用于定义抽取条件(可选);"condition": "minecraft:random_chance"表示抽取条件类型(条件来源:战利品表谓词);"chance": 0.6设置了抽取条件参数;"functions": []用于定义战利品表函数;"function": "minecraft:set_lore"指定设置了物品的lore(来源:物品修饰器。后面的set_name与enchant_randomly分别设定了物品的名字和随机附魔);"lore": ["A Diamond Sword!"]设定物品lore的内容…….
在游戏中加载后,使用/loot give @p loot loot_tables:items获取这个战利品表的内容。接下来我们生成一个箱子,并让这个箱子附带该战利品表。利用/setblock ~ ~1 ~ minecraft:chest{LootTable:"loot_tables:items"} replace指令在你上方一格处放置一个包含上述战利品表的箱子。
在前面的例子中,我们仅仅是简单的创建了一个自定义的战利品表,实际上正如前文所说,战利品表能让我们自定义和修改游戏中物品生成和生物掉落物的规则,对于战利品表的其它功能,请读者利用wiki自行摸索。此外,为了更高效地制作战利品表,你还可以利用一些专门的生成工具来辅助制作战利品表。
10.进度
进度(Advancements)是一种用来逐步引导新手玩家融入Minecraft,并给玩家提供挑战的系统。进度类似成就,但它们俩又有些区别。进度和成就的获取方式基本相同,不同于成就,进度可以在任何游戏模式下完成,在每个世界独立获得以及保存。而且进度也是像成就一项一步一步引导玩家,与成就不同的是,每一个进度彼此独立,不需要完成其上一个进度即可完成。在进度完成的同时,还会播放音效和获得经验。
在数据包中,进度是技术性JSON文件,储存在数据包的data/<命名空间>/advancements目录下。命令/advancement可授予或移除玩家的进度。在数据包中,每个进度都由一个进度文件定义,一个进度文件要按照进度数据格式来编写。
此节正在持续更新中……
在之前的教程中,我们重点介绍了数据包中常用的部分,如标签、函数、战利品表、配方、谓词和进度等。然而,数据包的功能远不止于此,它还包括了结构、维度、物品修饰器以及自定义世界生成等多个重要组成部分。为了更全面地掌握数据包的应用,你需要自行深入了解和探索这些额外的部分。
在继续深入了解和探索数据包的过程中,你会发现每个部分都有其独特的用途和强大的功能。
例如,结构部分允许你创建自定义的建筑物或地形,为你的MC世界增添独特的风景和特色。维度部分则允许你创建全新的游戏世界,为玩家提供全新的冒险和探索体验。而物品修饰器物品修饰器可在战利品表中为物品添加战利品表物品函数,使物品更符合你的游戏需求。
最后,自定义世界生成是数据包中最为复杂和强大的功能之一。它允许你通过编写JSON文件来定义游戏中世界的生成规则,从而创造出完全符合你想象的游戏世界。无论是生成独特的地形、植被、建筑,还是控制生物和资源的分布,自定义世界生成都能为你提供无限的创意空间。
三、实践:写一个属于自己的数据包
在学习完了数据包的相关知识后,你可以按照后续提供的示例教程逐步操作,尝试亲手构建一个数据包。这一实践过程至关重要,因为只有通过亲自动手,那些抽象的理论知识才能在你的脑海中生根发芽,逐渐转化为你能够熟练运用的技能。
当然,本文对于MC指令的详细讲解内容并不多。然而,在着手开发一个数据包之前,除了需要具备数据包相关的知识外,掌握MC指令也是必不可少的。因此,在后续的示例教程中,我将适当介绍一些指令的使用。若你想深入了解更全面的指令知识,建议你在MC的WIKI页面进行搜索和学习。请记住,如果在开发数据包的过程中出现了一些不能理解的问题,请一定要查阅WIKI,所以建议你在开发数据包时,浏览器里挂着WIKI网站随时准备查阅。
特别声明:接下来的教程里,本人的方法不一定是百分百最好的,仅供参考。而且使用的版本为1.20.1(除了特别说明以外)
1.坐标显示
需要的指令:scoreboard、data、execute等
原理讲解:我们可以在游戏中利用scoreboard指令创建三个有关玩家坐标的计分板,用于存储data指令获取到的玩家坐标数值。再利用execute指令进行条件限制和数据存储,并反复循环执行,以实时显示玩家坐标。
需要用到的指令语法讲解:
①scoreboard objectives add <计分板名> dummy:
语法:scoreboard objectives add <计分板名> <类型/标准> [<显示名称>]
含义:创建一个具有给定的名称、准则和显示名称(可选)的记分项。
dummy指虚拟型计分板,其分数只能通过命令修改,不被实体死亡等游戏事件影响。可用作事件标志、状态映射、货币等等。
②scoreboard objectives setdisplay sidebar <计分板名>:
语法:scoreboard objectives setdisplay <位置> [<*计分板名*>]
含义:在指定位置显示指定记分项的分数信息。
sidebar指在屏幕的右侧显示侧边栏。在列表的最上方显示记分项的显示名称,并显示玩家的高分榜。
③data get entity <目标> Pos[<0/1/2>]:
语法:不展示,因为非常复杂。具体可以查看*WIKI。
含义:获取指定实体(entity)的指定位置(NBT:Pos)的值。
Pos[<0/1/2>]:0代表玩家所在位置的X轴坐标,1代表玩家所在位置的Y轴坐标,2代表玩家所在位置的Z轴坐标。
你可以在指令的前面加上execute as @p store result score @s <计分板> run (data get entity <目标> Pos[<0/1/2>]),以存储data指令获取到的数值于指定计分板里。
④scoreboard players operation <目标选择器a> <计分板a> <运算> <目标选择器b> <计分板b>:
语法:scoreboard players operation <player: target> <targetObjective: string> <operation: operator> <selector: target> <objective: string>
含义:使用<selector: target>(选择器)所选实体在<objective: string>记分项上的分数作为输入,与<player: target>(目标实体)进行运算操作后把结果作为目标实体在<targetObjective: string>(目标记分项)上的分数。
其中运算支持以下计算操作:
+= 求和:把选择器的分数加到目标名称的分数上。
-= 求差:在目标名称的分数上减去选择器的分数。
*= 求积:将目标名称的分数设为目标名称的分数与选择器分数的乘积。
/= 求商:将目标名称的分数设为被选择器的分数除后的结果。
%= 求余:将目标名称的分数设为被选择器的分数除后得到的余数。
= 赋值:把目标名称的分数设为选择器的分数。
< 取较小值:如果选择器的分数比目标名称的分数小,则把目标名称的分数设为选择器的分数。
> 取较大值:如果选择器的分数比目标名称的分数大,则把目标名称的分数设为选择器的分数。
>< 交换选择器与目标名称的分数。 除><外,选择器在记分项上的分数会保持不变。可填在目标名称或选择器(但不能同时)用以代表所有正在被记分板追踪的实体。
利用计分板的赋值运算,我们可以将获取到的玩家坐标赋值到相应的计分板上。同时也可以将多个计分板的值赋在同一个计分板上,这样便于显示计分板。
了解了一些重要的指令语法后,你可以根据下面的参考代码自行理解其中的含义(数据包的创建请看数据包的结构部分):
1 | scoreboard objectives add pos dummy [{"text":"[玩家位置]","color":"yellow","bold":true}] |
解析:先创建了四个计分板:pos、x、y、z,分别用于记录位置、X轴、Y轴、Z轴的数值。pos的目的是将x、y、z三个计分板通过赋值合并到一起,便于显示。中间利用execute指令中的store分支进行数值存储,且有一定的针对性。需要注意的是,上面的代码需要循环执行才能实现玩家坐标实时显示的功能,而且只争对单人游戏。
2.计时器
需要的指令:scoreboard、execute、tellraw、title等
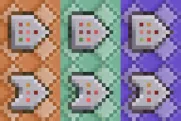
在写这个数据包之前,我们先尝试利用命令方块实现这个功能。首先介绍一下MC中命令方块的种类及其功能,这样好接下来的教程。先看左图:在MC中,共有三种类型的命令方块:脉冲型(橙色)、连锁型(青色)、循环型(紫色)。而每一种类型的命令方块又可以设置成两种制约模式:不受制约(图片上排三个)、条件制约(图片下排三个),以及两种运行模式:红石控制、保持开启。每一种类型的不同模式可以通过右击命令方块后打开的编辑界面进行调整。
脉冲:激活后执行一次指令;
连锁:只在指向它的命令方块执行命令时才会执行命令;
循环:激活时会在每一个游戏刻执行一次指令(即每秒20次)。
“条件制约”:只有当背后的命令方块成功执行命令时才会执行命令(“背后”的意思是该命令方块上箭头指向的反方向,无视连锁方向)。
“不受制约”:无论背后的命令方块是否成功执行命令(即使是没有指令),该命令方块都会正常执行命令。
“红石控制”:命令方块必须像红石机械一样激活才能执行命令。
“保持开启”:命令方块在没有红石信号时也会保持为开启状态 。
需要注意的是,除了连锁型命令方块之外,脉冲型和循环型命令方块都需要至少1游戏刻来激活。条件制约检测的是上一个命令方块在至少1游戏刻前是否成功而忽视同一游戏刻已经发生变化的状态,这就使得检测上一个命令方块是否成功会先于有条件的命令方块激活,即实际不在同一游戏刻内。不过延迟并不代表命令链在进程处理上的混乱,在较短的时间内命令链的结果仍然是相对有序的。
简单来说就是,除了连锁型命令方块,其他类型的命令方块都要等1游戏刻才会开始工作。它们会检查前一个命令方块是否成功,但不会立刻知道同一时刻发生的变化。虽然有点延迟,但整个命令链的工作还是有条不紊的。因此你需要格外注意连锁指令的顺序。
了解过后,咱直接按照下面的图片摆放命令方块,并输入对应的指令。指令的功能请自行摸索:
模块一:
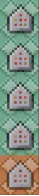
类型:脉冲/不受制约/红石控制(下面一个)、连锁/不受制约/保持开启(上面四个)
指令(从上往下):
tellraw @p {“text”:”计时器已重置”,”color”:”gold”}
scoreboard players set @p convert 20
scoreboard objectives add convert dummy
scoreboard players set @p Timer 0
scoreboard objectives add Timer dummy
模块二:
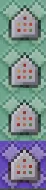
类型:循环/不受制约/红石控制(下面一个)、连锁/不受制约/保持开启(上面三个)
指令(从上往下):
execute if score @p convert matches ..0 run scoreboard players set @p convert 20
execute if score @p convert matches ..0 run scoreboard players add @p Timer 1
title @p actionbar [{“text”:”计时器: “,”color”:”yellow”},{“score”:{“name”:”@p”,”objective”:”Timer”}},{“text”:”s “,”color”:”yellow”}]
scoreboard players remove @p convert 1
设置完成后,你可以利用红石信号激活模块一的首个命令方块以初始化计时器相关的计分板,随后再利用持续的红石信号激活模块二的首个命令方块开启计时功能。这样你就能在物品栏上方标题处看到计时器的实时时间了。
原理:首先我们创建了两个计分板,分别为Timer和convert,一个用来计秒数,一个用来进制转换。在前文我们知道了1秒=20游戏刻,也就是说,每过20游戏刻,秒数才加1。所以先将convert计分板设置为20,Timer计分板设置为0。这会儿会在聊天栏显示:计时器已重置。
后面,我们通过循环执行模块二的指令,可以实现:每过1个游戏刻就将convert计分板的分数-1,当convert计分板分数为0时,重置convert计分板分数为20,并同时将Timer计分板分数+1。这里构成了一个条件循环,以实现计时功能。这会儿会在物品栏上方标题处实时显示:计时器:<秒数>s,其中<秒数>是Timer计分板的分数。
很好,我们已经通过命令方块成功实现了所需的功能。然而,由于我们现在正在学习数据包的相关知识,接下来我们的任务是将这些命令方块组转换为数据包中的函数文件。
按照前面的原理,我们可以很容易创建一个用来实现模块一功能的函数(这里我命名为time_reset.mcfunction):
1 | scoreboard objectives add Timer dummy |
那么对于需要循环执行的模块二呢?回忆前文所学,我们可以利用schedule指令实现循环,只需要在函数最后一行加上schedule指令就行(这里我命名为time_run.mcfunction):
1 | scoreboard players remove @p convert 1 |
创建完上面两个函数后,你可以先使用/function <命名空间>:time_reset初始化计时器,然后使用/function <命名空间>:time_run指令开启计时器功能。这样就可以获得与之前直接使用命令方块时完全相同的计时器功能了。那么怎么停下这个计时器呢?你可以额外创建个新的函数,用来删除计分板和计划(这里命名为reset.mcfunction):
1 | schedule clear timer:time_run |
你可以使用/function <命名空间>:reset终止循环,同时也删除了计分板。当你下一次想用时,可以再次执行/function <命名空间>:time_reset和/function <命名空间>:time_run以开启计时器。当然,你可以再次借鉴之前进制转换的思路,尝试将小时和分钟都显示出来,这样你就可以拥有一个完整功能的计时器了。不仅如此,你还可以将其改造成定时器,用来倒计时,你甚至还可以在此基础上实现,当倒计时结束后执行某一个指令/函数。
你可能会很好奇,在计时器这一节的教程里,我为什么要把命令方块给引进来。这是因为命令方块是开发数据包时的一个非常实用的工具。你可以利用它在游戏中进行实时调试,省去了反复输入/reload命令的繁琐步骤。一旦你的功能通过命令方块(组)得到了实现,你可以轻松地将这些命令转换为数据包中的函数。随着你对数据包的熟练度不断提高,你将能够直接在文本编辑器中编写数据包,进一步提高开发效率。
3.特殊武器
先简单的介绍一下这个所谓的特殊武器是啥。你玩MC服务器玩的多的话,你应该见过或者了解过RPG服务器的一些厉害的道具,比如闪电弓(当箭落下时召唤落雷)、爆炸弓(当箭落下后直接爆炸)、吸血鬼之刃(敌人受击时会持续掉血,同时转换为自己的血)等。
接下来我们来尝试写一个特殊武器的数据包,这个武器的基础设定为: [闪电霹雳弓]箭矢飞行时尾部带有粒子特效,当箭矢落地后会在落地处召唤一道落雷,同时产生一个小型爆炸。当然,你在此基础上加点炫酷的粒子特效也不是不行。
需要的指令:execute、data、particle等(同时你还需要了解实体格式、NBT路径格式这两个重要的概念)
注:接下来的教程很长,所以我不会过多的介绍上面指令的用法。在教程开始前请自行查阅相关语法和功能!
首先你得准备好一把弓,利用give指令进行获取:
1 | give @p minecraft:bow{display:{Name:"[{\"text\":\"闪电霹雳弓\",\"color\":\"dark_purple\",\"bold\":true,\"italic\":false,\"underlined\":false,\"strikethrough\":false,\"obfuscated\":false}]",Lore:["{\"text\":\"--------------------------\",\"color\":\"aqua\",\"bold\":true,\"italic\":false,\"underlined\":false,\"strikethrough\":true,\"obfuscated\":false}","{\"text\":\"左手持有时,发射箭矢后将会在落地处召唤落雷\",\"color\":\"yellow\",\"bold\":false,\"italic\":false,\"underlined\":false,\"strikethrough\":false,\"obfuscated\":false}","{\"text\":\"--------------------------\",\"color\":\"aqua\",\"bold\":true,\"italic\":false,\"underlined\":false,\"strikethrough\":true,\"obfuscated\":false}"]},Tags:["lightning_bow"],Unbreakable:1b,HideFlags:7,Enchantments:[{id:"minecraft:flame",lvl:5s},{id:"minecraft:infinity",lvl:1s},{id:"minecraft:looting",lvl:5s},{id:"minecraft:knockback",lvl:2s},{id:"minecraft:power",lvl:10s}]} 1 |
这样你就获得一个带有特殊标签(见Tags[“lightning_bow”])、自带附魔(见Enchantments[…])、有自定义的名字和介绍标签(见display中的Name和Lore)的一把弓。设置一个标签的目的为了区分普通的弓,这一点在后面的讲解中能体现。
为了避免逐个输入指令带来的繁琐和潜在错误,我推荐你使用一款实用的小工具——命令方块指令生成器。通过它,你可以轻松地编写指令,极大地提高效率和准确性。因此,熟练掌握并运用这类指令工具,也是编写数据包时不可或缺的一项技巧。
接下来,我们进入功能主体部分的编写。其核心原理如下:当我使用这把弓发射箭矢时,会首先检测箭矢是否成功发射。若箭矢存在,系统将触发相应的粒子显示指令。待箭矢落地后,一系列事件将按序发生,首先是召唤闪电,紧接着是召唤爆炸物(例如TNT或苦力怕等),然后再次显示特定的粒子效果,最后清除落地的箭矢。
飞行中的箭矢监测相对简单,我们只需要使用execute if entity指令结合选择器@e[type=minecraft:arrow]来检测是否有一个类型为“箭”的实体存在。一旦箭矢被检测到,我们就可以通过粒子效果指令来为其添加视觉效果。
为了实现粒子显示,我们需要了解并应用particle指令。这个指令允许我们自定义粒子效果的位置、速度、数量等属性。特别地,由于我们希望粒子效果跟随箭矢的位置,我们可以在execute指令中通过at @e[type=minecraft:arrow] positioned ~ ~ 来定位到箭矢的当前位置。这里 ~ 代表相对于执行实体的相对位置,由于execute是在箭矢实体上执行的,所以这三个分别代表箭矢的X、Y、Z轴方向的偏移量,由于我们不需要偏移,所以都是~。
接下来,我们将使用火焰粒子效果(minecraft:flame)来显示。完整指令如下:
execute if entity @e[type=minecraft:arrow] at @e[type=minecraft:arrow] positioned ~ ~ ~ run particle minecraft:flame ~ ~ ~ 0 0 0 0.01 1 force
接下来是落地时的箭矢监测。我们可以利用箭的实体数据中的“inGround”标签来监测箭是否在地面或者击中方块。你只需要在上面的指令中稍作修改,完整指令如下:
execute if data entity @e[type=minecraft:arrow,limit=1] {inGround:1b} at @e[type=minecraft:arrow,limit=1] positioned ~ ~ ~ run particle minecraft:flame ~ ~ ~ 0 0 0 0.3 50 force
上面的指令的意思是:当检测到类型为“minecraft:arrow”的最近一个(limit=1)箭实体(如果存在)的“InGround”标签值为1b时,在该箭实体的位置触发火焰粒子效果。且粒子效果的速度、数量参数被设置为0.3和50,确保粒子效果以一定的速度和数量显示。
随后我们继续添加闪电召唤指令:execute if data entity @e[type=minecraft:arrow,limit=1] {inGround:1b} at @e[type=minecraft:arrow,limit=1] positioned ~ ~ ~ run summon minecraft:lightning_bolt ~ ~ ~
关于爆炸物的选择,你有TNT和苦力怕两种选项。虽然使用summon命令可以召唤一个被点燃的TNT(其默认爆炸时间为0t,即Fuse:0),但TNT的Fuse标签仅用于定义爆炸时间,无法调整其爆炸威力,且对爆炸后方块破坏的控制较为困难。
相比之下,选择利用苦力怕进行爆炸则更为灵活。同样通过summon命令召唤苦力怕,其Fuse值默认为30t,但你可以自定义这个参数。此外,苦力怕还具备ExplosionRadius标签,这允许你调整其爆炸的威力。若你希望控制爆炸是否破坏方块,可以通过gamerule命令将mobGriefing(生物破坏)设置为false,这样苦力怕爆炸后将不会对方块造成损害。
值得注意的是,mobGriefing规则不仅影响苦力怕的爆炸效果,还决定了其他生物(如僵尸、末影人、恶魂等)是否能进行破坏性行为,包括方块的放置、修改或破坏,以及物品的捡拾。此外,它还会影响村民的繁殖和某些生物寻找海龟蛋的能力。然而,这一规则对TNT和末地水晶等非生物实体不产生影响。另外,如果你想利用苦力怕作为爆炸物,需要确保游戏难度设置在简单以上。
若遇到需要保持和平模式且不允许破坏地形的特定情境,你可以巧妙地运用一系列指令来模拟爆炸的视觉效果和听觉效果。具体而言,你可以设计一套机制,在箭矢落下的瞬间,立即触发爆炸烟雾粒子效果的生成,营造出逼真的爆炸氛围。同时,为了增强沉浸感,你还可以播放相应的爆炸音效,让玩家仿佛置身于真实的爆炸现场。除此之外,为了模拟爆炸对周围环境的破坏效果,你可以通过穷举的方式,在爆炸影响范围内放置空气方块,以此来模拟地形被炸毁的视觉效果。
当然,如果你希望在箭矢落地时伴随一个炫酷的粒子图案,你可以基于上述指令进一步编写几串粒子显示的指令。然而,要构建一个由粒子组成的图案,若每个粒子代表图案中的一个或多个像素,逐一编写这些指令会相当繁琐且耗时。为了更高效地生成这些指令,你可以借助一些工具来辅助完成,比如这里推荐的Particle-Converter。
假设你要添加一个法阵的粒子图案,我们先可以在这个网站中下载你喜欢的图案:https://ciaccodavi.de/qbdp/acg/,然后将其导入Particle-Converter,设置好后导出mcfunction文件即可。
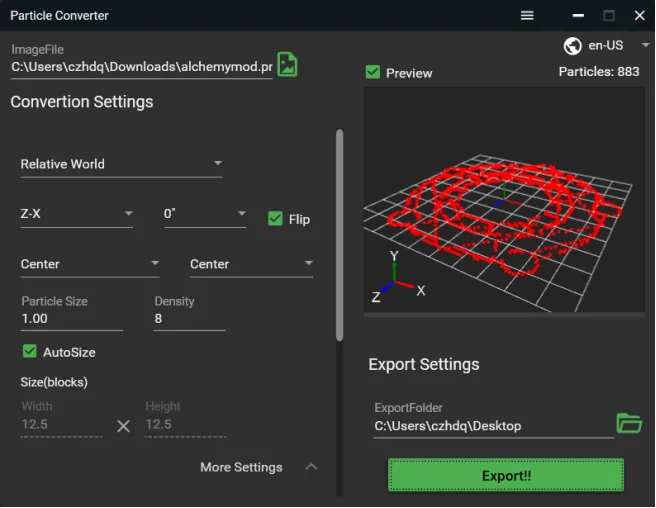
最后,为了避免游戏卡顿,我们需要利用kill指令来清除落地的箭矢,这是为了防止指令循环执行导致的性能问题。毕竟,持续地召唤闪电、苦力怕(或TNT)以及产生粒子效果都会给游戏带来不必要的负担,影响游戏体验。
那么上述功能的完整代码如下(命名空间为lightning_bow,其中主功能的函数命名为main.mcfunction,未加入特效粒子图案):
1 | execute if entity @e[type=minecraft:arrow] at @e[type=minecraft:arrow] positioned ~ ~ ~ run particle minecraft:flame ~ ~ ~ 0 0 0 0.01 1 force |
你会发现上面有很多条件判断重复的语句,于是我们可以给它简化一下,将有相同条件的指令集成为一个新的函数文件(inground.mcfunction):
1 | particle minecraft:flame ~ ~ ~ 0 0 0 0.3 50 force |
然后回到main.mcfunction中将重复的部分改写成:
execute if data entity @e[type=minecraft:arrow,limit=1] {inGround:1b} at @e[type=minecraft:arrow,limit=1] positioned ~ ~ ~ run function lighting_bow:inground
这也是写指令的一个技巧,你可以通过“合并同类项”,让每一个函数文件中的代码量变的更为精简,从而便于查阅和后续的修改工作。
最终,你可以通过在游戏中设置循环型命令方块来执行main函数,或者利用tick标签进行全局循环,亦或者使用schedule指令来构建指令的循环机制,这样,一把威力强大的闪电霹雳弓便完成了它的构造。
在这里我分享一下我自己临时想出来的一个小创意,在上面指令的基础上,我们加上execute as @a[nbt={Inventory:[{Slot:-106b,id:”minecraft:bow”,tag:{Tags:[“lightning_bow”]}}]}] at @a[nbt={Inventory:[{Slot:-106b,id:”minecraft:bow”,tag:{Tags:[“lightning_bow”]}}]}] positioned as @a[nbt={Inventory:[{Slot:-106b,id:”minecraft:bow”}]}] run function lighting_bow:main,这样就可以实现在玩家用副手拿取这把弓的时候才能触发函数的效果(还有个有趣的就是,如果你先发射一个箭矢,然后在切换副手,这样你就获得了一个可遥控的闪电霹雳弓了x)。
对于上面的那个目标选择器,你可以先将弓切换到副手,然后利用*/data get entity @p*指令查询你的数据,执行后在聊天栏你可以看到一大串的内容,找到如下图所示的内容:
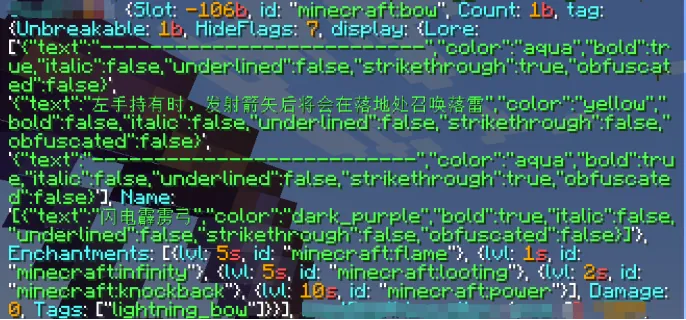
Slot代表的是槽位,-106b表示副手的槽位,后面就是该槽位上的物品以及其自带的一些标签数据。你可以选择性的添加至目标选择器(在上面的指令中我只添加了这把弓的标签部分),这样就不会与普通的弓弄混了。
4.玩家数量检测
在很多小游戏的玩法中,玩家进入小游戏等待室后,需静待片刻并期待更多玩家加入,以凑齐人数开始游戏。这样的机制广泛存在于各类小游戏之中,既可通过插件灵活配置,也能借助数据包轻松实现。接下来的教程中,我们会尝试利用MC原版指令还原一个玩家数量检测系统。
需要了解的指令:scoreboard、execute、trigger等
首先,我们需要创建一些计分板,用于玩家数量计数和时间计数。玩家计数我们需要通过execute指令检测玩家的数量。创建一个名为set.mcfunction的文件,在里面填入一下指令:
1 | # 玩家数量计分 |
接着创建一个循环函数,以检测在线玩家数量。同时附带人数条件判断,以执行不同的指令。比如,当在线人数满两人或两人以上时,触发倒计时;当未满两人或两人以上时,仅在动作栏显示提示文本。创建一个名为main.mcfunction的文件,将指令输入进去:
1 | # 设置分数,并打开分数存储(当玩家存在时+1) |
最后别忘记在之前set.mcfunction文件里加上function players:main指令以在执行set函数时触发主循环。于是这样一个玩家数量检测计分板就完工了。你可以直接利用load.json函数标签设置set函数,这样能在地图或数据包加载时直接开启检测功能。
以上的玩家数量检测是强制的,争对的是多人游戏中所有的玩家。在一个游戏房间内,总有玩家是不想参与的,所以我们还得额外对玩家进行筛选。不妨换个思路,我们通过让玩家设置计分板分数以确认已加入的玩家总数,并以此作为条件判断决定是否开启游戏。
但我们需要知道,在多人游戏中,非管理员玩家是无法执行大多数原版指令的,尤其是计分板分数设置。不过好在原版指令中提供了一个触发型计分板,玩家可以在非管理员权限下执行计分板分数设置指令。
例:触发型计分板的使用:运行/scoreboard objectives add abc trigger指令创建一个名为abc的触发型计分板;接着执行/scoreboard players enable <目标选择器> abc为指定的玩家添加触发指令权限;接着,这个玩家就可以在没有管理员权限的情况下通过执行/trigger abc add/set <分数>为abc计分板设置分数,执行后失去触发指令权限。也就是说,给玩家开启触发权限后,玩家只能使用一次触发指令,随后就会失去触发权限。
我们可以利用这个原理,为玩家创建一个触发型计分板,当玩家想加入游戏时输入触发指令,同时将触发计分板的分数存储至“已加入人数”的目标内,并以此作为开始游戏的判断依据。当然,你还得考虑当一个已经加入的玩家退出游戏后,“已加入人数”的分数变化,这使得你还得创建用于判断“已加入人数”的分数变化的函数。
根据上面的提示,你可以尝试自行完善玩家数量检测系统,同时我也会分享我自己创建的数据包供读者参考学习:PlayersCount
5.奖励箱
在许多探索、解密等类型的游戏中,奖励箱是个非常常见的元素,为玩家提供了丰富的奖励和惊喜。在此小节中,我们会尝试利用MC的指令制作一个奖励箱的数据包。接下来的教程里,你只需要能熟练的看懂execute指令就行,因为整个逻辑部分十分简单,甚至用不上计分板和其它指令(因为这些似乎在前面的教程挺常见的x)。
特别说明:1.本人采用的是1.20.1版本;2.数据包命名为Chests,并且存放战利品表的文件夹命名为loot_tables。3.本人的代码不一定是最优解
首先你得创建一个战利品表(Chests\data\loot_tables\loot_tables\items.json,其实就是前面战利品表章节的示例),用于生成奖励箱的物品。在这个战利品表示例中,我为奖励箱添加了钻石(随机数量)、下界合金锭(随机数量)、钻石剑(随机附魔),你可以根据自己的需要自行修改。
1 | { |
在游戏中加载好数据包后,利用/setblock ~ ~2 ~ minecraft:chest{LootTable:"loot_tables:items"} replace指令在你上方两格处放置一个包含上述战利品表的箱子。箱子已经成功生成了,接下来还要为奖励箱添加点功能,比如当玩家拿取完所有物品后箱子自动消失。
这个容易,我们可以利用execute指令配合data进行条件判断,我们还可以利用data指令获取某个方块的数据信息。根据前面生成箱子的位置,我们可以利用/data get block <箱子坐标> Items来获取箱子的物品信息。但奇怪的是,当你生成好箱子再执行指令后,会出现“没有与Items相匹配的元素”的信息,即使你使用/data get block <箱子坐标>获取该箱子的所有数据信息,都无法找到有关Items的条目。不过奇怪的是,当你打开了箱子,发现里面是有物品的,并且再次执行/data get block <箱子坐标> Items指令后发现,聊天栏出现了关于这个箱子的Items数组。
通过上面的现象可以发现,当你通过指令生成一个箱子时,它内部即使有物品,也无法被data指令(准确来说是/data get block <箱子坐标> Items指令)检测到;只有你打开这个箱子后,data指令才会生效。这种现象让我想起了薛定谔的猫(x)。
由于这种“薛定谔的箱子”特性的存在,导致我们很难利用execute来进行条件判断。为了打破这种特性,我们需要额外的操作才能刷新这个箱子的物品数据,从而才能进行条件判断,也就是说,如何在没有玩家操作的情况下刷新这个箱子,成了这个数据包的难关。
经过我大量的实验和观察发现,除了玩家主动操作打开箱子能刷新以外,还可以通过红石激活(如在箱子旁边放一个红石比较器,利用比较器的特点激发刷新)、漏斗放入(在箱子上方放置一个漏斗,并且在漏斗内放入物品,让物品自然落入箱子内)的方式刷新物品数据。
不过,又经过一些实验和调试后,使用漏斗激活的方式较好,因为假设你利用指令生成箱子后再在旁边生成一个红石比较器,那么这个比较器也会出现一种不确定的状态(不信你可以自己试试),但使用漏斗激活的方式不会出现这样的特性。于是我们可以利用这样的逻辑链来刷新箱子状态:生成箱子—在箱子上方生成一个漏斗—在漏斗里填入物品—延时后立刻将漏斗清除。
示例代码:(函数文件路径:Chests\data\chest_commands\functions\xxx.mcfunction)
1 | #summon_chest.mcfunction: |
1 | #delay.mcfunction: |
1 | #check_chest_contents.mcfunction: |
1 | #clear_chest.mcfunction: |
当你写完这个数据包并在游戏中加载后,你可以运行/function chest_commands:summon_chest在-233 -61 276处召唤一个奖励箱。
6.跑酷挑战
在许多Minecraft服务器的大厅中,跑酷挑战是个常见的大厅休闲项目。跑酷,本身也是MC中一个比较有特色的休闲玩法,从国内到国外,也有许许多多有趣而且充满挑战的跑酷地图。不过,这里我们不聊怎么建筑,而是教你怎么用数据包给跑酷加点料,比如加上计时器和奖励。接下来,咱们就一起用之前学过的计时器和奖励箱数据包,给跑酷游戏加上计时和奖励功能吧!
初步设想是:玩家按下一个“开启挑战”的按钮时,在附近生成一个跑酷的场地,随后玩家立刻被传送至跑酷挑战起点处。当玩家在规定时间内完成挑战,将会为玩家生成奖励箱,否则没有奖励。
首先,你必须要准备好场地,比如下面这个简单的跑酷场地:
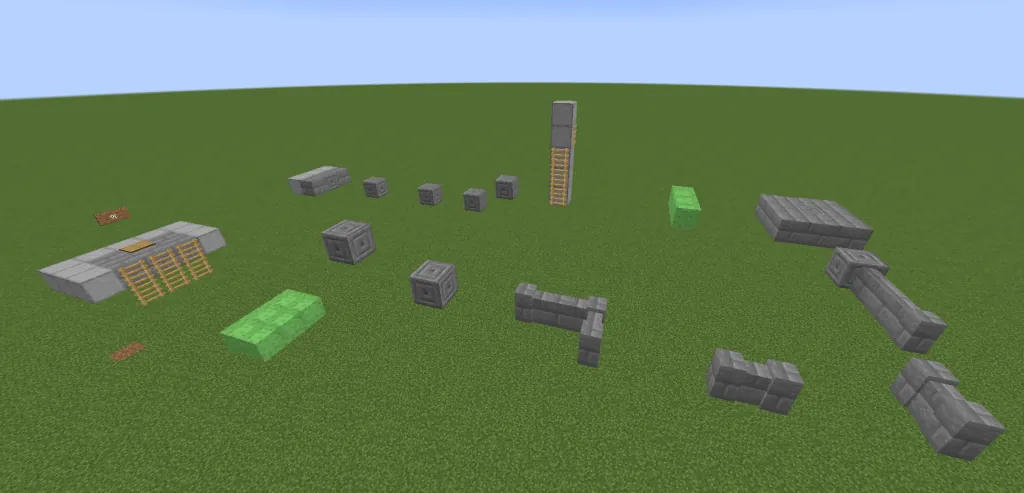
接下来,你需要获取一个结构方块来保存这一部分建筑(具体教程请自行查阅)。结构方块的功能是保存和加载游戏结构。同时,它可以被红石激活(加载模式下的结构方块被红石信号激活后会直接生成相应的结构)。
所以整个跑酷挑战的大致原理是:当玩家开始游戏后(比如点击某一个开启按钮),玩家会被自动传送至跑酷的出生地处,同时计时器(倒计时)开始计时。当玩家在规定时间内到达了终点(我们可以在终点放一个压力板,当玩家踩住时就说明玩家到达终点了),玩家会被自动传送出跑酷场地,并在其身边生成一个奖励箱(可以利用前面的教程),否则,玩家传送出场地后无奖励箱生成。同时,为了挑战方便,我们可以设置一个“临时重生点”,当玩家掉下时,会把玩家自动传送回跑酷起点。
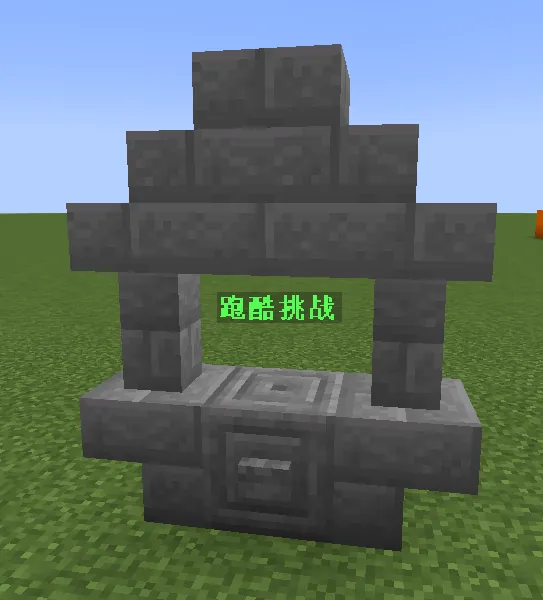
首先你可以像左图那样建一个跑酷挑战的“标志”,点击下面的按钮可以开启挑战。不过本着不出现红石的原则(越简单越好),这是一个“伪按钮”,它的附近并没有任何用于执行指令的命令方块,但是当它被按下时,依然可以执行指令。
其实只需要在数据包创建一个用于检测这个按钮状态的循环函数就行:第一条指令的意思是,当一个处于指定位置(坐标:-234 -60 273)的并有指定状态(被激发:powered=true)的指定方块(石质按钮:minecraft:stone_button)存在时,执行后面的函数(这个函数就是用来开启跑酷挑战的)。也就是说,平常状态下的石质按钮是处于未激发的状态,并不能触发这个指令的条件判断;只要玩家按下按钮时,条件满足,立刻执行指令。
顺着这个思路,就可以很好的理解第二条指令的意思了,第二条指令在第一条的基础上,替换了一个放置方块的指令,不难看出,当按钮按下后,除了会执行开始函数,还会将这个按钮又更新为未激发状态。这并不是多余的操作,因为石质按钮按下后会保持1s的激发状态,而在这期间,这个循环函数会持续执行多次,但我们只需要执行一次就行,所以得马上恢复按钮的状态。这个函数你可以利用数据包的tick.json函数标签,让其在全局游戏中保持循环。
1 | execute if block -234 -60 273 minecraft:stone_button[powered=true] run function parkour_functions:parkour_start |
对应的tick.json可以这样写:
1 | { |
接下来是创建开始函数。不过在开始写这个函数之前,你需要找一个合适的场地,并在合适的位置放置一个结构方块(加载模式,并且填入你保存的跑酷场地的结构),准备好后,就可以回到这个函数了。
开始函数要负责计时器的开启和跑酷场地的生成,同时要更新一切的函数状态(比如利用schedule指令的地方),当然你还可以加入文本提示、音效之类的:
1 | # parkour_start.mcfunction |
从开始函数中就能看出接下来有哪些函数了。我们一个一个来写。在前文提到,我们需要一个玩家掉落后自动传送回出生点的机制,这个机制就靠fall_back.mcfunction函数来实现,具体如下:
1 | # fall_back.mcfunction |
很明显,这是一个待激活的循环函数,第一条指令的意思是,选定一个区域(这个区域是一个以-239 -61 284为原点,分别向x、y、z轴方向延伸13格、0格、32格的立方体。这个区域刚好能包含跑酷场地下方的一部分地方),并以这个区域为参考,当此区域存在玩家时(玩家进入这个区域时),执行传送指令(传送位置和角度得视情况而定)。
计时器部分的原理你可以参考前文的计时器教程,在本例中,time_reset.mcfuction是重置函数,time_run.mcfunction则用于运行计时器,同时你可以往里面添加一个条件判断,以下是示例:
1 | # time_reset.mcfunction |
1 | # time_run.mcfunction |
而parkour_end.mcfunction函数其实原理和功能与tick.mcfunction函数差不多,用于检测玩家是否到达终点,咱只要把石质按钮替换为木质压力板就行:
1 | # parkour_end.mcfunction |
同时你也能发现多了一个parkour_finish2函数,这是用于判断玩家在规定时间内完成了挑战的判断函数,当玩家在规定时间内完成了挑战(到了终点触发了压力板),就会视为挑战成功:
1 | # parkour_finish2.mcfunction |
从time_run.mcfunction函数中也不难发现我们还需要clear_structure函数和parkour_finish函数。无论挑战是否成功,到最后我们都得整一个清除函数,用于清除生成的跑酷场地,这就是clear_structure函数的作用。你可以直接使用fill指令填充空气方块实现,同时,由于这个函数是挑战结束时执行的,我们可以再往里面加点音效或者文本提示之类的指令,来为整个跑酷挑战收尾。(作业:请根据这段描述,自行编写clear_structure.mcfunction函数。)
接下来是parkour_finish.mcfunction函数,你只需往里面塞各种结束循环的指令就行:
1 | # parkour_finish.mcfunction |
至此,整个跑酷挑战的数据包已完成。你会发现,这个跑酷挑战的数据包与之前的奖励箱数据包和计时器数据包都有关联,奖励箱我们是直接调用了之前的奖励箱数据包的,而跑酷倒计时则参考了前面计时器数据包的原理,在这里,我们可以将前面的奖励箱数据包视为这个跑酷挑战数据包的一个前置第三方库。这种第三方前置库的好处在于,它把一些常用的功能打包在一起了,这样当我们想给其他的数据包增加新功能时,就变得非常简单。而且,我们不需要在每个数据包里都重复写这些功能的代码,这样既能减少代码里重复的部分,也能让你的工作变得更轻松。同理,你完全可以将之前的计时器也制作成便于其它数据包调用的数据包,不仅可以为跑酷挑战使用,也可以为其它需要诸如此类功能的数据包使用。
7.寻路系统
在Minecraft众多RPG服务器中,你经常要去某个地方做任务。为了方便玩家找到这些地方,很多服务器都会加一个寻路系统。这些系统大多是用插件或模组做出来的。但在这篇教程里,我要教大家怎么用数据包来做一个寻路系统。
当然事先声明一下,这个数据包有许多未完善的地方,也存在着一些难以捉摸的bug(看到后面你会明白的),而且由于这个数据包完全是靠我自己慢慢查wiki摸索出来的,所以不一定是最优解,仅供参考;同时请注意一点,此节不会过多的展示各部分代码,只会讲解大概的思路,不过我会在最后分享完整的数据包,有兴趣的读者可以自行下载查看和使用。同时还得事先说明一件事,这一节的教程十分长,同时也涉及一些数学与算法的知识,请做好心理准备。
接下来正式开始教程。这个寻路系统分为几个板块,分别为玩家坐标显示、目标点坐标显示、距离显示、寻路引导,为了便于查阅,我会将这些板块分成几个小节讲解。
7.1 坐标显示
在我的这一款寻路数据包中,分为两个坐标显示,一个是玩家坐标显示(在侧栏),一个是目标点坐标显示(在动作栏)。其实坐标显示十分简单,首先我们需要创建一系列用于存储坐标值的计分项,分别用名为“x”、“y”、“z”的计分项来存储玩家的坐标值;分别用“x_setpos”、“y_setpos”、“z_setpos”来存储目标点的坐标值。
对于目标点,我们可以选用一个带有特殊标签的盔甲架来充当目标获取的工具,带有特殊标签是为了便于区分,你可以利用一个被替换了NBT的刷怪蛋来充当这个盔甲架的生成工具,give指令如下:
1 | give @p minecraft:ocelot_spawn_egg{display:{Name:"[{\"text\":\"【位置获取】\",\"color\":\"gold\",\"bold\":true,\"italic\":false,\"underlined\":false,\"strikethrough\":false,\"obfuscated\":false}]",Lore:["{\"text\":\"右击获取坐标\",\"color\":\"aqua\",\"bold\":false,\"italic\":false,\"underlined\":false,\"strikethrough\":false,\"obfuscated\":false}","{\"text\":\"切副手打开全息预览模式\",\"color\":\"dark_aqua\",\"bold\":false,\"italic\":true,\"underlined\":false,\"strikethrough\":false,\"obfuscated\":false}"]},Tags:["setpos"],HideFlags:4,Enchantments:[{}],EntityTag:{CustomName:"[{\"text\":\"get_pos\",\"color\":\"gray\",\"bold\":false,\"italic\":true,\"underlined\":false,\"strikethrough\":false,\"obfuscated\":false}]",Tags:["setpos"],CustomNameVisible:1b,Invisible:0,Small:1,Glowing:1b,ShowArms:0,Rotation:[0f],Pose:{Head:[0f,0f,0f],Body:[0f,0f,0f],LeftArm:[0f,0f,0f],RightArm:[0f,0f,0f],LeftLeg:[0f,0f,0f],RightLeg:[0f,0f,0f]},id:"minecraft:armor_stand"}} 1 |
接下来就是获取坐标了,参考前面的教程1中的玩家坐标实时显示,你可以很容易的看懂下面的函数:
1 | # player_getpos.mcfunction |
1 | # armorstand_getpos.mcfunction |
7.2 距离计算
有了上面玩家和目标点的坐标,我们就可以利用公式来计算空间中两点的距离了。根据数学知识,我们可以知道,给定空间中两点A(x1,y1,z1),B(x2,y2,z2),根据公式我们可以计算出AB两点的距离d=√(x2-x1)²+(y2-y1)²+(z2-z1)²。
但是,对于MC数据包来说,计分板只支持加减乘除等运算,无法进行开方与平方计算,平方计算好说,咱可以直接利用计分板乘法算得,但开方确实比较难实现。也就是说现在的问题转化为了,在只允许加减乘除等运算法则的情况下计算某个数的平方根。
这里我们引入一个名为牛顿迭代法的方法。牛顿迭代法(Newton’s method),又称为牛顿-拉弗森方法(Newton-Raphson method),是一种在实数域和复数域上近似求解方程的方法。它使用函数 f(x) 的泰勒级数的前几项来寻找方程 f(x) = 0 的根。如果函数 f(x) 是连续的,并且待求的零点 x 是孤立的,那么在零点 x 周围存在一个区域,只要初始值 x0 位于这个邻近区域内,那么牛顿法必定收敛。它的计算公式如下(其中,xn是第 n 次迭代的近似解,f(xn)是目标函数,f’(xn)是f(xn)的导数,xn+1是基于xn计算出的下一个近似解。):xn+1=xn-f(xn)/f’(xn)
举个例子,我们想要求某数的平方根,比如√2=?,我们可以假设√2=x,变形一下:x²-2=0,也就是说,求平方根的问题转换为了求方程的解。
接着根据牛顿迭代法的步骤,我们可以令f(x)=x²-2,则f’(x)=2x。现在我们需要选定一个初始值x0=1(初始值是随便选的,也可以根据情况选用;初始值的选用会影响迭代的次数),于是我们可以计算出x1=1.5、x2=1.375、x3≈1.429、x4≈1.41…通过多次迭代,我们可以逐渐逼近方程的根。在实际应用中,通常会设置一个容忍度或最大迭代次数来停止迭代过程。以防无休止的迭代下去,为计算机增加负担。
当然,对于MC数据包来说,因为我们最终是要显示距离的值,而MC中只允许显示整型数据,无法显示浮点型(小数),而距离的值必须大于或等于0,因此我们还得通过一个算法进行取整和取绝对值。
以下是我根据上述原理自行编写的一个可以求某数平方根近似值的函数:
1 | # 开方函数calculate_sqrt.mcfunction |
整个函数可以简单概括如下:
设置计分板:
- guess1:用于存储当前迭代的猜测值。
- ito:常数2,用于公式中的除法部分(实现除以2的效果)。
- one:常数1,可能用于确保猜测值不会低于1。
- check:用于存储当前猜测值的平方。
- distance2:用于计算新的猜测值。
- check2 和 compare:辅助计分板,用于比较和条件判断。
初始化:
设置常数计分板ito为2,one为1,compare为200(用于控制迭代精度)。如果guess1小于或等于1,则将其设置为1,确保初始猜测值合理。
运算环节:
将distance(我们想要开平方的数)复制到distance2。使用distance2和guess1来计算新的猜测值,对应牛顿迭代法的公式。这里通过两次操作实现了除以2的效果:先除以guess1,再加上guess1,最后再除以ito(2)。计算check作为当前猜测值distance2的平方。
将distance复制到check2,并从check中减去check2,得到差值,用于判断当前猜测值的准确性。
条件判断与迭代:
如果check(当前猜测值的平方)等于distance,说明找到了精确的平方根,将distance2赋值给distance。如果不相等,则更新guess1为distance2,准备进行下一次迭代。另一个条件判断是用于控制迭代的精度:如果check与distance的差值小于或等于compare(200),则也认为找到了足够的近似值,并停止迭代。
接下来就是获取这个distance的值了,这下就非常简单了,有了前面的两点坐标的获取,接下来只需要按照公式代入即可。
1 | # 空间距离计算函数 |
7.3 寻路算法
目标点有了,距离显示有了,接下来是整个寻路系统中最重要的一部分:寻路。在众多的寻路系统里,指引通常通过明显的标记来展示,这些标记可能是NPC跟随指引,亦或是粒子指引。而在这个数据包中,我选择了粒子指引作为路线呈现的方式。
其实我有一个非常简单粗暴的方法来实现寻路。在MC中,流浪商人有一个特殊的实体标签:wander_target,它代表流浪商人的目的地。内部的三个整数分别代表了位置的XYZ坐标值。我们可以通过以下指令让这个流浪商人(流浪商人的标签为path_finder)自行往目标点移动:
1 | data modify entity @e[tag=path_finder,limit=1] WanderTarget.X set from entity @e[tag=setpos,limit=1] Pos[0] |
我们利用MC中生物实体自带的生物AI且只用了三行指令就实现了寻路的核心功能,接下来就是将这个流浪商人隐藏起来并给他加上粒子跟随效果。不过你还得要考虑,当我在白天下给流浪商人强行加上隐身药水效果,他会自行饮用牛奶恢复,由于我们的隐身效果是循环给予的,于是流浪商人会一直拿着牛奶桶饮用,期间发出大量的声音,为了隐藏这些,我们可以利用指令将牛奶桶和声音都屏蔽了,牛奶桶我们可以利用item replace指令将流浪商人手上的牛奶桶替换为空气;声音我们可以在流浪商人召唤时将他的Silent标签设置为1b。
1 | # 核心模块 |
不过,利用MC生物AI来寻路还是有些弊端,比如利用流浪商人时,他很难主动去开门,导致寻路中止;又或者当他到达目的地附近时,哪怕此时只相隔了一格的墙,他也会终止寻路。
这时候我们不得不使用一些特殊的算法来寻路了。穷举法是一种直接且简单的方法,它尝试所有可能的路径,然后从中选择出到达目标的最优路径。这种方法虽然直观易懂,但效率极低,特别是在复杂的环境中,可能的路径数量会呈指数级增长,导致计算量巨大,难以在合理的时间内找到解。
鉴于穷举法的局限性,A*算法作为一种更为高效和智能的寻路算法应运而生。A*算法结合了最佳优先搜索算法和Dijkstra算法的优点,通过引入启发式函数来评估节点到目标点的估计成本,从而有效减少搜索空间,提高搜索效率。
A*算法基于一个启发式函数,该函数为每个节点提供一个“预估代价”,表示从该节点到目标节点的估计距离。算法通过计算每个节点的总代价(即起点到该节点的实际代价与从该节点到终点的预估代价之和),来选择下一个要遍历的节点。总代价最小的节点被优先考虑。
也就是说,通过A*算法,寻路程序避免了像穷举法那样盲目地尝试所有可能的路径,让寻路更高效。也因此A*算法被广泛用于游戏开发、机器人导航、地图路径规划等领域。关于更多有关A*算法的讲解,你可以观看相关科普视频来了解。
所以现在的问题就变成了,如何在MC中利用指令模拟出一个寻路的算法程序。幸运的是,我找到了有关寻路算法的数据包(原链接:PlanetMinecraft,本人根据前面的数据包改版并优化了一下:PathFinder)。在使用这个数据包前,咱们得先清楚在MC中如何实现寻路算法。在A*算法中,为了“探索”并构建路径,我们会采用特定的数据结构来表示这些路径,并且这些数据结构还用于提供算法运行过程中所必需的值。在A*算法的常见讲解中,经常采用“方格”(或称为网格)这种作为数据结构的代表,这样做的主要目的是为了能够更加直观和信息的清晰地行为可视化。而在MC中,我们可以利用盔甲架来充当这个工具。
有了一个基本的了解后,接下来就是使用这个数据包了。这个数据包内包含三种算法:A*算法、最佳优先搜索算法、Dijkstra算法,又根据评估函数的不同,A*算法又分为A*算法-欧里几得距离和A*算法-曼哈顿距离。同时它还包含一个设置菜单,可以设置各种参数,比如是否可视化、是否对角、最大步长设置、步数设置。
你可以直接下载这个数据包然后慢慢研究,但需要注意的是,这个数据包内的寻路算法并不支持Y轴方向上的搜寻,因此,你得确保设置的起始点和终点必须在X-Z平面内。还有一件事,为了放置生成过多的盔甲架,造成卡顿,你需要将最大步长设置在合理的范围内。
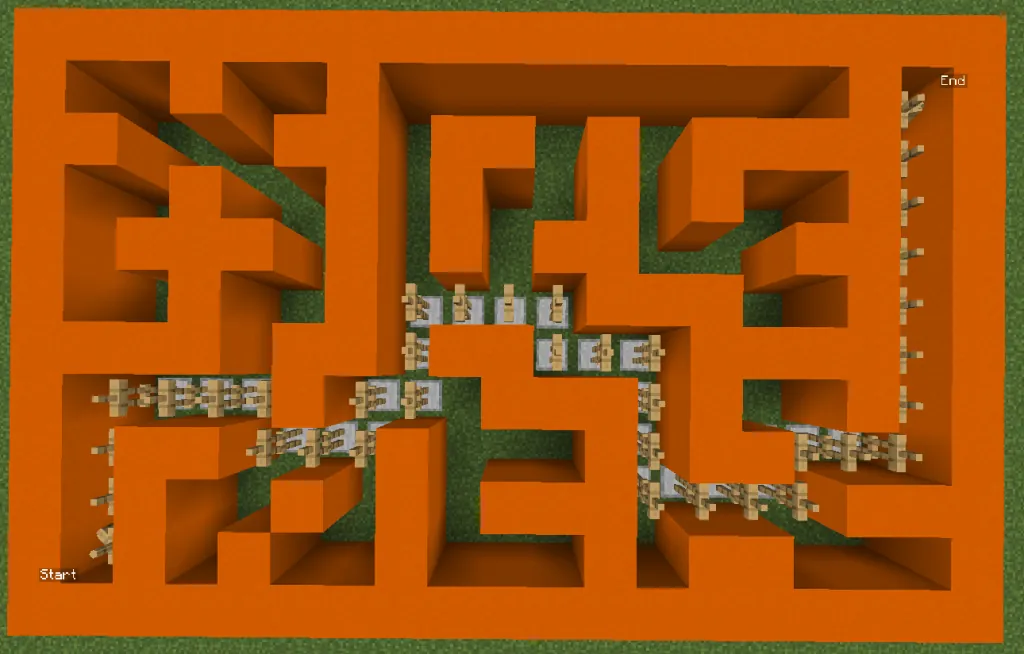
但是,在MC利用指令实现寻路算法有时会不尽人意,就拿这个数据包来说,虽然它已经提供了一个很好的算法框架,但是也存在一些缺点。比如,由于这个数据包是利用盔甲架来充当工具寻路的,假设你的目标点离得远,它会召唤一大堆盔甲架造成卡顿;还有,哪怕路径上存在一些红石、梯子、门之类的非方块的东西,它也会阻挡路径的搜索,这样很可能会错开最佳路线。
因此,有些情况下,直接利用MC生物自带的AI还是可以粗略的实现寻路功能的。在接下来的时间里,我会不断完善我的这个寻路数据包,所以说它(的链接)会一直更新下去。
未完待续……