人工智能硬件探秘:从CPU到类脑芯片
从数据中心到边缘设备,AI 的每一次运算都离不开硬件的支撑。本文带你认识 CPU、GPU、TPU、NPU、FPGA 与类脑芯片的工作原理、适用场景与取舍,并展望量子计算、DNA 计算等前沿方向。
本文聚焦于硬件层面,深入探讨人工智能与硬件设备之间的紧密关联,介绍市面上出现的硬件设备(CPU、GPU、TPU、NPU等)对人工智能的影响。
CPU:通用计算的“中枢大脑”
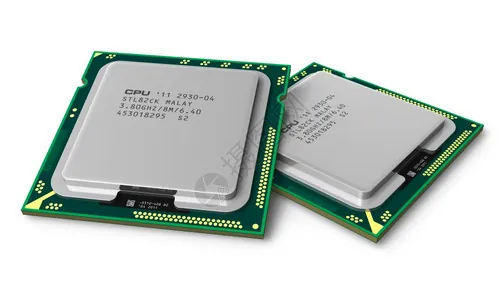
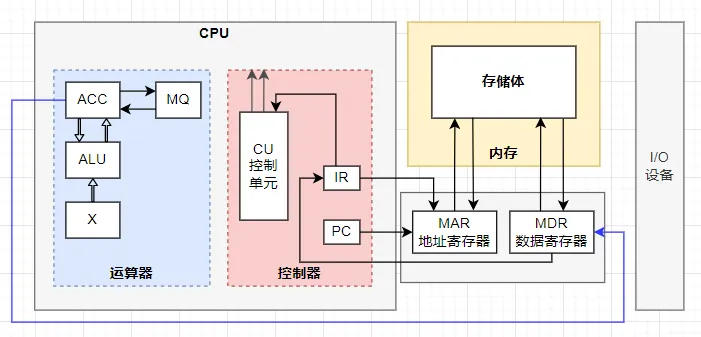
CPU——中央处理器(Central Processing Unit,简称CPU)作为计算机系统的运算和控制核心,是信息处理、程序运行的最终执行单元。其架构设计以通用计算为导向,典型的CPU由运算器(ALU,算术逻辑单元)、控制器(CU,控制单元)、寄存器组和高速缓存(Cache)等部分组成。
运算器负责执行各种算术和逻辑运算,如加、减、乘、除以及与、或、非等逻辑操作。控制器则从内存中读取指令,对其进行解码,并向运算器和其他部件发出控制信号,协调整个计算机系统的运行。寄存器用于临时存储数据和指令,以加快处理速度。高速缓存则分为多级(L1、L2、L3),用于缓存频繁访问的数据和指令,减少CPU从内存中读取数据的延迟。
CPU通常采用多核设计,多个核心可以并行处理不同的任务,提高系统的整体性能。然而,由于CPU的核心数量相对较少,且每个核心的设计更侧重于处理复杂的逻辑和顺序任务,其并行计算能力相对有限。
在人工智能领域,CPU虽然算力不如一些专用硬件,但它在AI系统的全流程中扮演着不可或缺的角色。在数据预处理阶段,CPU凭借其强大的逻辑控制能力,能够高效地完成数据清洗、转换和特征提取等任务。
此外,CPU还负责协调和管理整个AI系统的运行,包括任务调度、内存分配、I/O操作等,像个超级管家一样。在一个包含多个GPU或专用加速器的AI训练服务器中,CPU需要合理分配计算任务,确保各个硬件组件能够高效协同工作。
GPU:并行计算的“超级引擎”
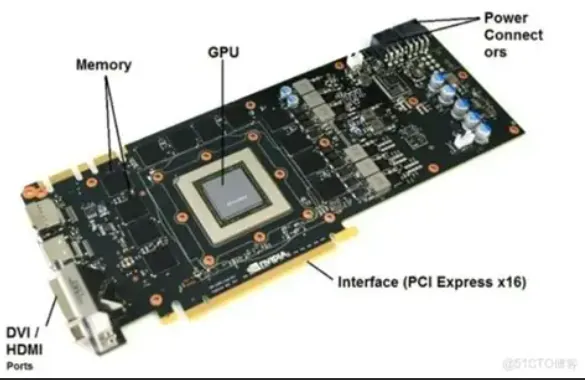
GPU(Graphics Processing Unit,图形处理器)最初是为图形渲染而设计的,其架构以大规模并行计算为核心。GPU由大量的流式多处理器(SM,Streaming Multiprocessor)组成,每个SM包含多个CUDA核心(NVIDIA架构)或流处理器(AMD架构),以及共享内存、寄存器等资源。
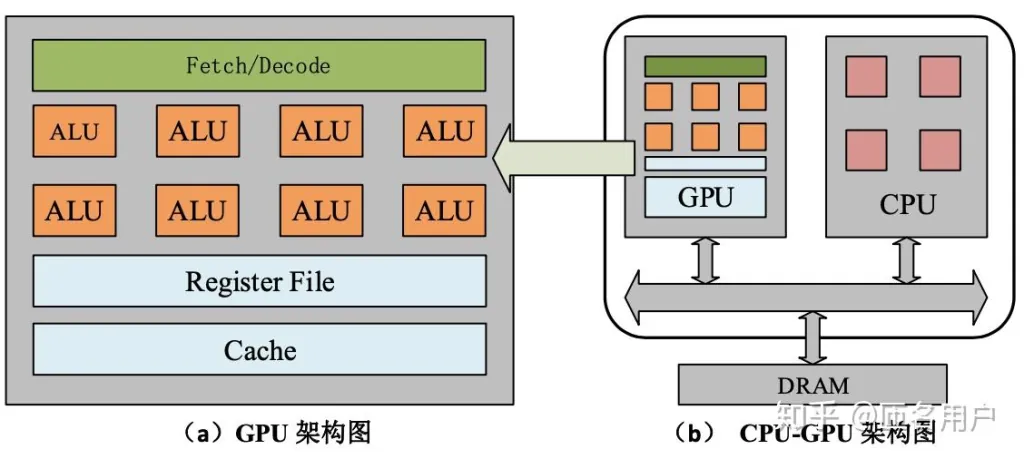
随着深度学习的兴起,GPU凭借其强大的并行计算能力,迅速成为深度学习训练的核心硬件。深度学习模型通常涉及大量的矩阵乘法和卷积运算,这些运算具有高度的并行性,与GPU的架构特点高度契合。
在模型训练过程中,GPU能够显著缩短训练时间,而且GPU还支持大规模模型训练。随着人工智能技术的不断发展,模型的规模越来越大,参数数量也越来越多,GPU的高算力和大显存能够支持训练千亿甚至万亿参数的大型模型,如GPT - 3、BERT等。
当前,大多采用CPU-GPU混合架构进行深度学习框架的运行——这样可以使得计算资源互补,提升整体性能。先由CPU负责数据预处理,之后将处理好的数据传输至GPU;GPU凭借强大并行计算能力,开展大规模矩阵与向量运算,完成模型训练迭代。训练中CPU与GPU分工协作,期间数据在二者间按需传输,最终借助GPU高效计算完成深度学习任务。
通俗易懂的说,CPU就好像一个厉害的数学家,专门处理复杂的逻辑推理、精细的顺序控制任务,会将复杂的计算转换成基本的加减乘除;而GPU就像一群只会加减乘除基础运算的小学生,虽然单个能力有限,但数量众多且能齐心协力,通过数量上的优势快速完成大规模的矩阵乘法、向量加法等重复且简单的运算任务。
TPU:专为AI定制的“算力利器”
TPU(Tensor Processing Unit,张量处理单元)是谷歌公司专门为机器学习任务设计的专用集成电路(ASIC)。在相同工作负载下,TPU的能效比传统GPU高很多倍。TPU的核心是矩阵乘加单元(MXU,Matrix Multiply - Add Unit),它采用脉动阵列(Systolic Array)架构。
脉动阵列是一种特殊的并行计算架构,由大量的处理单元(PE,Processing Element)组成一个二维网格。在矩阵乘法运算中,数据按照特定的节奏在处理单元之间流动,每个处理单元只负责计算矩阵乘法中的一个乘加操作,并将结果传递给相邻的处理单元。这种架构减少了数据搬运和指令开销,能够高效地执行大规模的矩阵乘法运算。
TPU还配备了专门的向量处理单元(VPU,Vector Processing Unit)和标量处理单元(SPU,Scalar Processing Unit),用于处理向量运算和标量运算。此外,TPU还具有大容量的片上内存,能够缓存大量的模型参数和数据,减少与外部内存的交互,提高计算效率。
TPU是专为AI任务设计的硬件,在大规模AI训练中具有显著优势。由于其针对张量计算进行了高度优化,TPU在训练大型语言模型和计算机视觉模型时能够实现更高的算力和能效比。
NPU:边缘智能的“能效之星”
NPU(Neural Processing Unit,神经网络处理器)是专为设备端AI推理设计的专用芯片。NPU通常采用脉动阵列架构和专用指令集,支持低精度计算。
与GPU和TPU不同,NPU的设计目标是在低功耗的前提下实现高效的神经网络推理。为了降低功耗,NPU采用了多种技术,如优化电路设计、降低工作电压、采用低功耗制程工艺等。同时,NPU还支持动态功耗管理,根据任务的负载情况自动调整功耗和性能。NPU的脉动阵列架构能够高效地执行卷积、池化、激活函数等神经网络中的常见运算。专用指令集则针对神经网络的特点进行了优化,减少了指令开销,提高了计算效率。
FPGA:灵活多变的“硬件加速器”
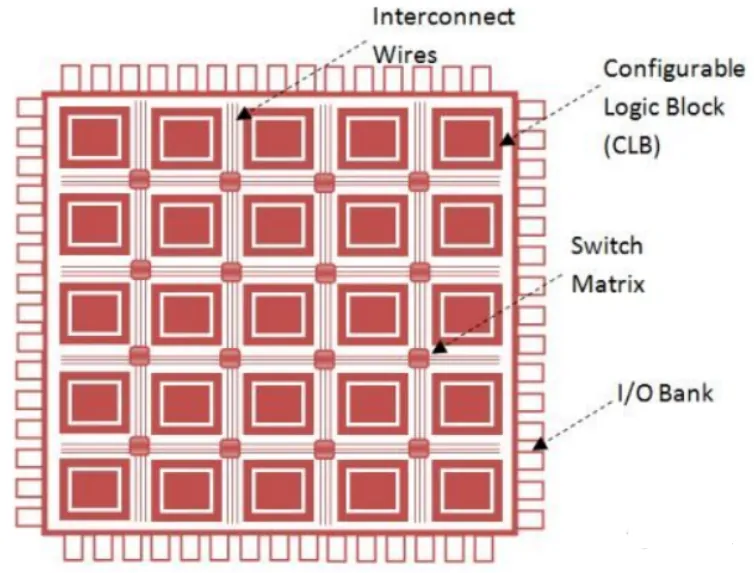
FPGA(Field - Programmable Gate Array,现场可编程门阵列)是一种可编程的集成电路,它由大量的可编程逻辑单元(CLB,Configurable Logic Block)、输入输出单元(IOB,Input/Output Block)和可编程互连资源组成。用户可以通过硬件描述语言(如Verilog或VHDL)对FPGA进行编程,实现特定的硬件功能。
简单来说,它就像一个可供你选择的积木盒,里面的可编程逻辑单元恰似盒中种类繁多、功能各异的积木块,三角形的、方形的、圆形的,每一种都能依据不同的搭建创意,组合出独一无二的逻辑构造。
FPGA的灵活性是其最大的优势之一。与ASIC(专用集成电路)不同,用户可以根据实际需求对FPGA进行重新编程,实现不同的硬件功能,以适应多种应用场景。在深度学习领域,FPGA理论上可以根据不同的神经网络模型和算法进行定制化设计,实现高效的硬件加速。甚至对于SNN(脉冲神经网络)来说,我们可以利用FPGA专门打造一个合适的硬件平台供其运行。
补充:SNN模拟生物神经元的脉冲发放与传递机制,其独特运行模式要求硬件平台具备与之类似的特性。当前的硬件架构并未能完全的发挥出SNN的优势。而我们可以通过精心设计FPGA的硬件架构,合理配置逻辑单元和互连资源,我们可以为SNN构建一个高效、低功耗且可灵活调整的硬件运行环境。
类脑芯片:模拟大脑的“智能先锋”
类脑芯片是一种模拟人脑神经元和突触结构的芯片,旨在实现类似人脑的智能计算。人脑具有高度的并行性、低功耗和强大的学习能力,类脑芯片试图借鉴人脑的这些特点,构建更加高效、智能的计算系统。
类脑芯片通常采用忆阻器等新型器件来模拟神经元和突触的功能。忆阻器是一种具有记忆功能的电阻,其阻值可以根据通过的电荷量发生变化,类似于神经元之间的突触权重。通过大量的忆阻器组成阵列,类脑芯片可以实现神经网络的基本运算,如矩阵乘法和向量加法。
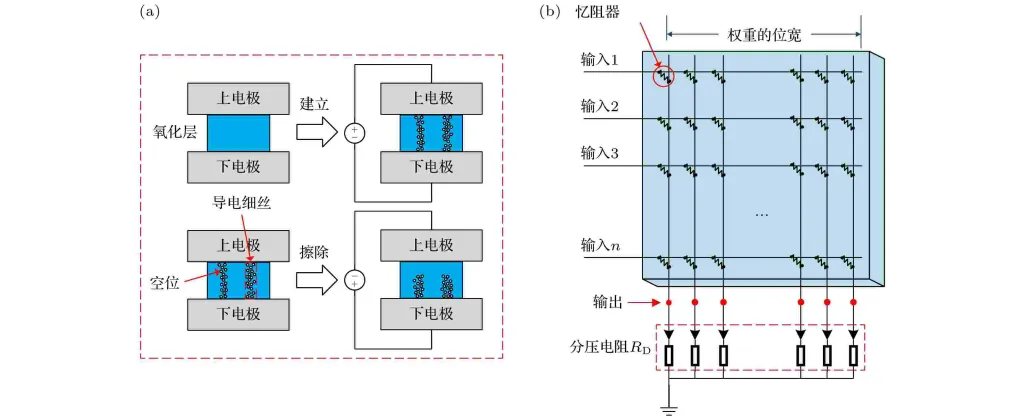
从本质上来说,以忆阻器为器件搭建的类脑芯片架构采用的是一种更为高效的运算,它与传统的冯诺依曼结构不同,传统冯诺依曼结构中,存储单元和计算单元相互分离,数据需要在两者之间频繁传输,这就如同货物运输需要在仓库和加工厂之间来回奔波,不仅耗费大量时间和能量,而且随着数据量的爆炸式增长,这种“运输瓶颈”问题愈发凸显,严重限制了计算速度和效率。
而类脑芯片架构则巧妙地打破了这种限制,它借鉴了生物大脑的运作模式,将存储和计算功能有机融合在一起。忆阻器阵列就像是一个个微小而智能的“神经元站点”,它们不仅能够存储信息(阻值变化代表不同信息),还能直接在本地进行计算(利用阻值变化实现运算)。这种原位计算的方式极大地减少了数据传输的距离和次数,就如同在每个生产车间都配备了仓库,货物无需长途运输就能直接进行加工处理,大大提高了运算效率,降低了能耗。
目前,类脑芯片的研究还处于起步阶段,但已经取得了一些重要的成果,未来有望成为人工智能领域的重要发展方向。
当然,前沿技术也在不断涌现。例如,量子处理器(QPU)融合了量子计算与AI,有望在未来实现超高速计算。同时,科学家们也在研究利用生物材料进行计算和存储,比如DNA计算和DNA存储技术、生物组织芯片等,以及探索使用碳基材料替代传统硅基制造芯片,以实现更低的能耗。